
> «Я оставил AutoResearch крутиться на два дня. Агент нашёл ~20 улучшений в коде, который я вручную оптимизировал месяцами. Все изменения оказались аддитивными и перенеслись на более крупную модель. 11% speedup к GPT-2 бенчмарку.»
Среди двадцати улучшений был баг в реализации attention. В коде, который Карпаты — бывший директор по ИИ в Tesla — написал сам и считал чистым.
Машина нашла ошибку создателя. Брутфорсом. Пока создатель спал.
За первую неделю репозиторий набрал 42 тысячи звёзд и 8.6 миллионов просмотров. Большинство восприняло это как утилиту для ML-инженеров — ещё один скрипт для оптимизации обучения нейросетей.
Я увидел другое. Карпаты показал, как выглядит [работа Архитектора] в 2026 году.
Три файла и одна идея
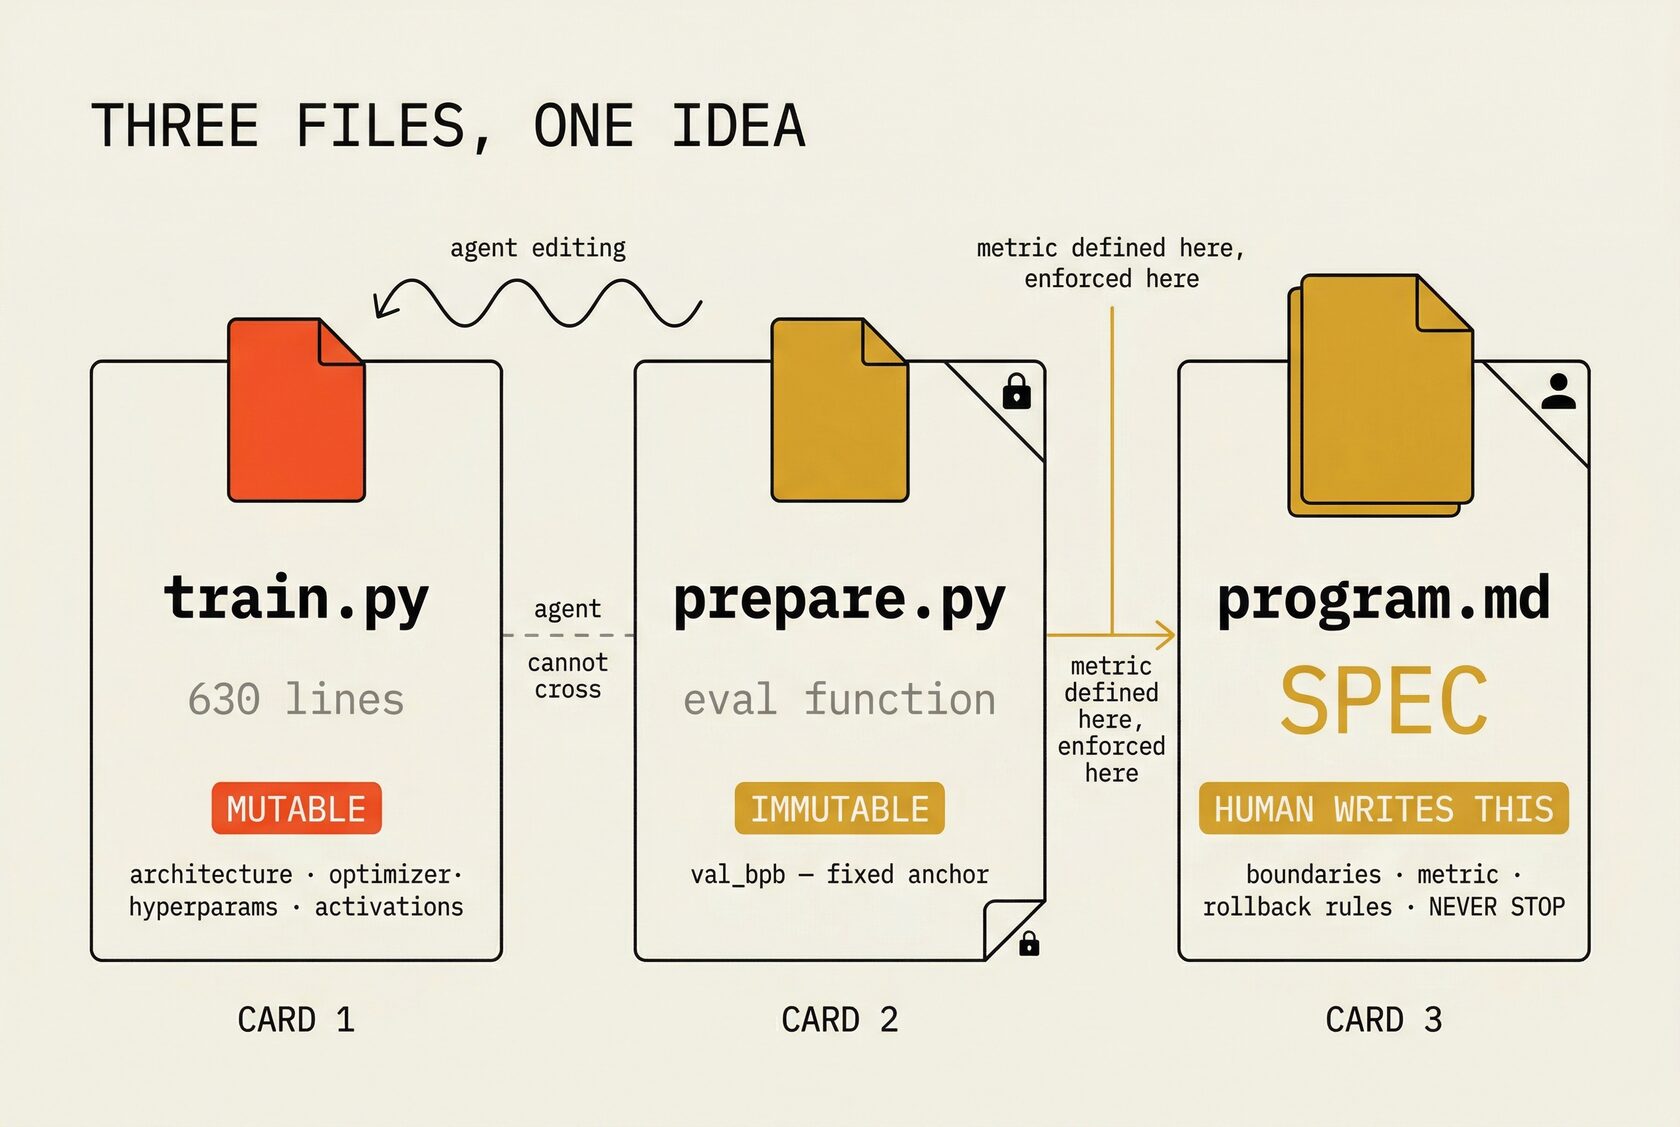
train.py — 630 строк кода, который агент имеет право менять. Архитектура, оптимизатор, гиперпараметры, функции активации. Всё открыто для мутаций.
prepare.py — eval. Определяет метрику (validation bits-per-byte) и функцию проверки. Этот файл нельзя трогать. Ни агенту, ни человеку. Метрика — фиксированная точка, якорь.
program.md — спека. Единственный файл, который пишет человек.
Вот что внутри program.md:
- Что оптимизировать: train.py
- Что нельзя трогать: prepare.py
- Жёсткое ограничение: 5 минут на эксперимент
- Правило простоты: «All else being equal, simpler is better.» Маржинальные улучшения ценой роста сложности — штраф. Удаление кода, которое сохраняет метрику — награда
- Директива: «NEVER STOP» — агент работает бесконечно, не спрашивая разрешения
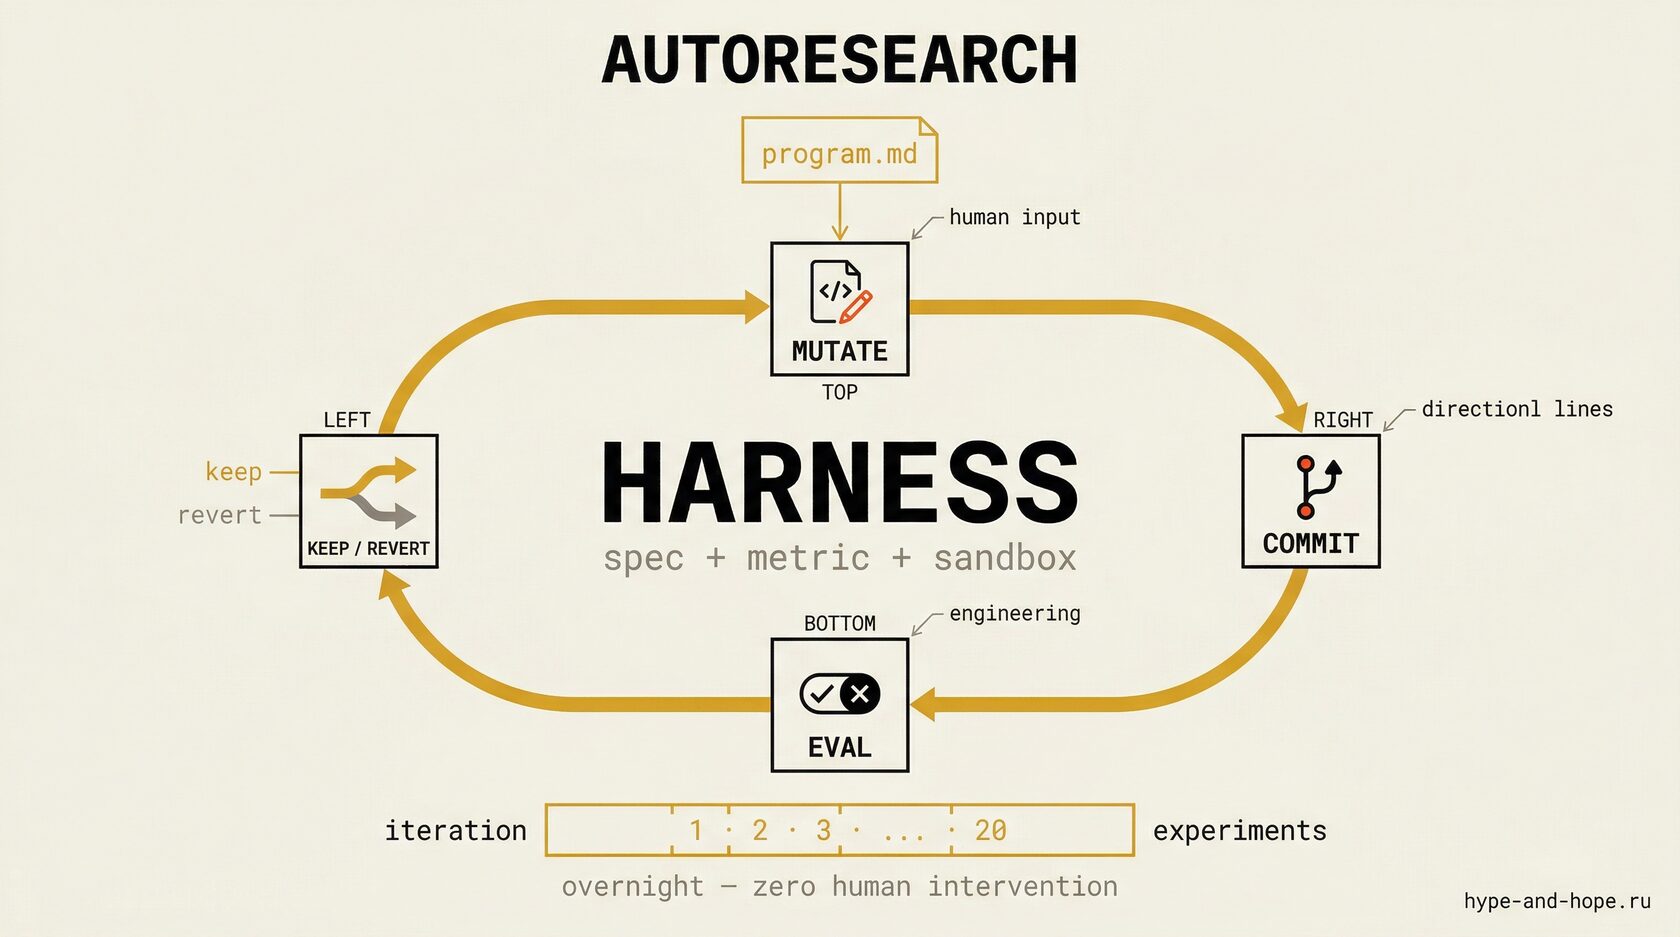
Цикл: агент редактирует train.py → git commit → запуск на 5 минут → проверка метрики → если лучше — оставить коммит, если хуже — git revert. Повторять.
~12 экспериментов в час. ~100 за ночь. Без участия человека.
Если вы читали [«Промпт — пожелание. Спека — контракт»] — вы уже узнали этот паттерн. program.md — это спека. Границы, метрика, условие отката. Промпт говорит «попробуй». Спека говорит «вот контракт, по которому ты работаешь».
Без спеки harness невозможен. Агенту нужен контракт, а не пожелание.
Три кейса: от голосового бота до бейсбольной подачи
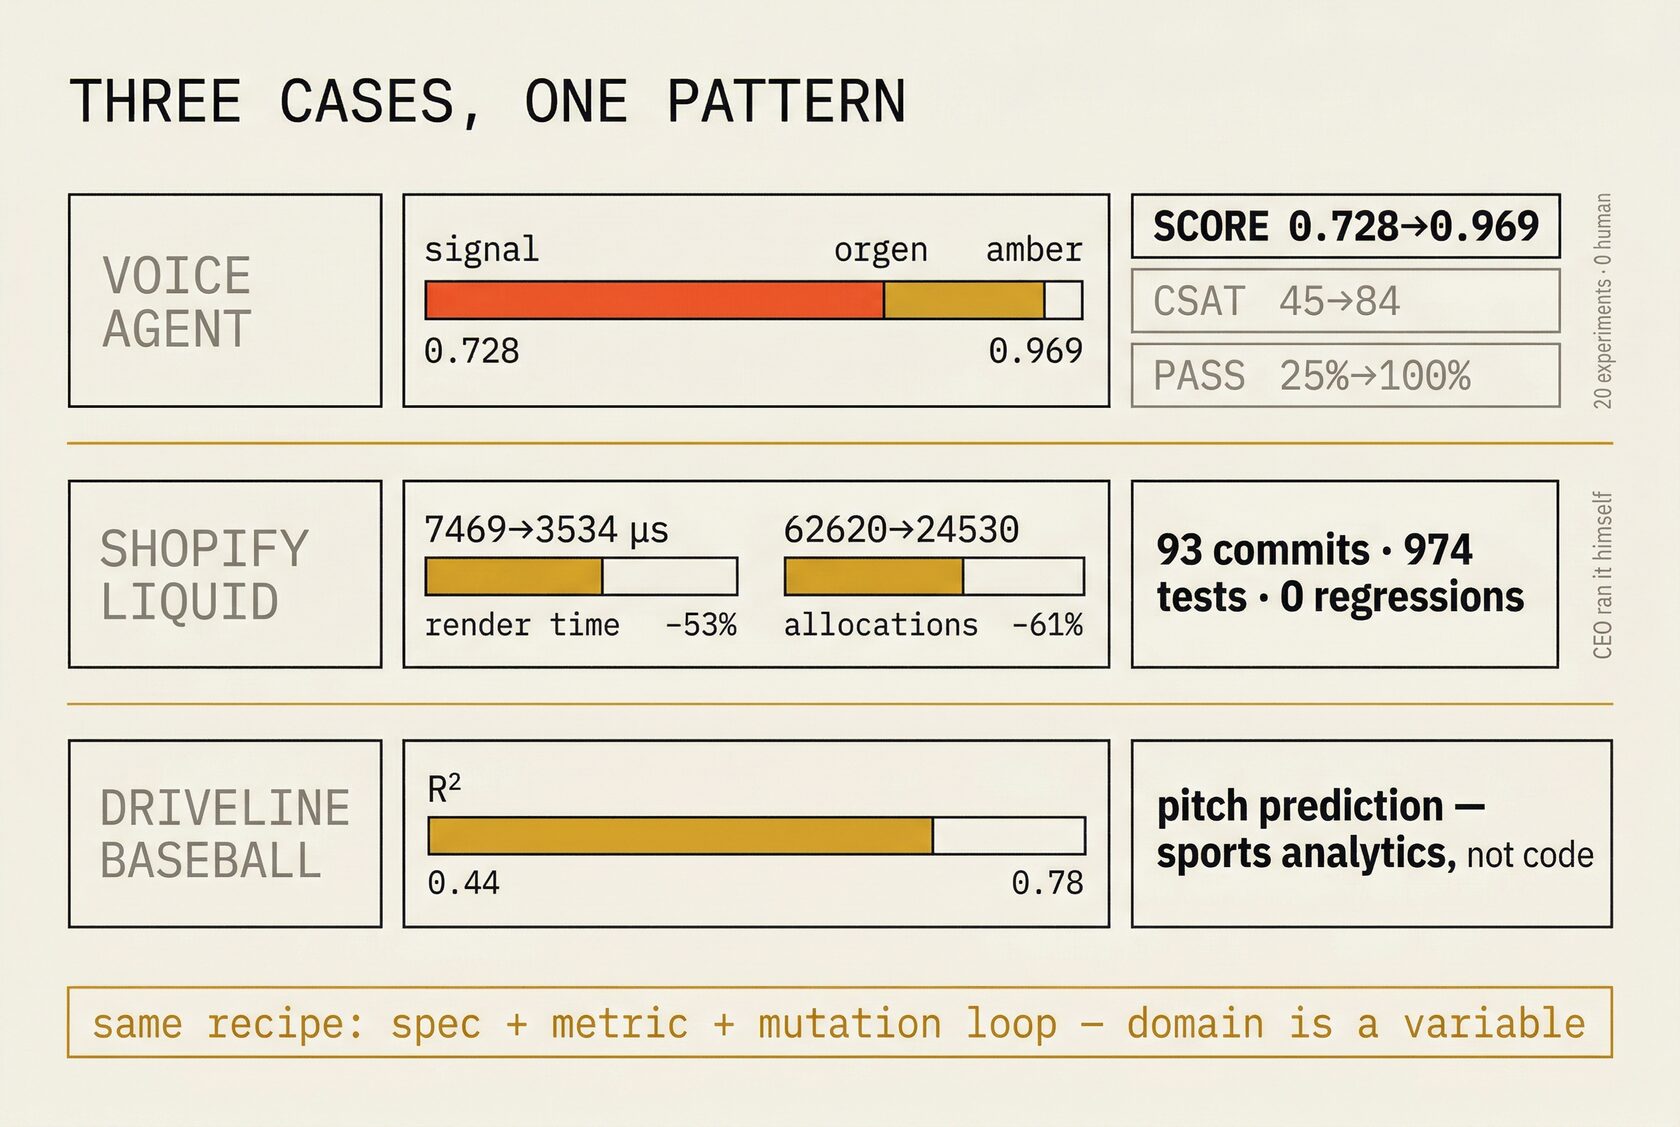
Три кейса, которые я хочу разобрать. Специально выбраны из разных доменов.
Голосовой агент: промпт мутирует сам
20 экспериментов. Ноль ручных вмешательств.
Результат: скор 0.728 → 0.969. CSAT 45 → 84. Pass rate 25% → 100%. Промпт при этом стал короче — с 1191 до 1139 символов.
Агент перебрал 20 версий промпта, каждую прогнал через eval и оставил лучшую. Ты больше не гадаешь, как сформулировать задачу для бота поддержки. Ты отдаёшь базу старых диалогов, задаёшь метрику — и идёшь спать.
Shopify Liquid: CEO натравил агента на движок
~120 экспериментов. 93 прошли фильтр и стали коммитами.
Parse+render: 7,469 → 3,534 µs (−53%). Object allocations: 62,620 → 24,530 (−61%). 974 юнит-теста. Ноль регрессий.
Ключевая деталь: Лютке заранее подготовил «gym» — liquid-spec на GitHub, набор прогрессивно усложняющихся задач из продакшена Shopify. Без этого gym — без eval-инфраструктуры — запускать было бы нечего. Тесты существовали до агента.
Любой внутренний скрипт, который работает медленно — парсинг лидов, выгрузка из CRM, формирование отчётов — можно скормить этому циклу. Ты не платишь senior-разработчику за оптимизацию. Ты платишь за токены. Стоимость одной мутации mid-tier моделью в 2026 году: меньше $0.001. Тысяча мутаций — меньше доллара.
Driveline Baseball: спорт-аналитика, не код
Это за пределами программирования. Здесь нет кода, который «оптимизируется». Есть модель, есть метрика, есть пространство мутаций. Паттерн работает.
Один и тот же рецепт: спека + метрика + мутационный цикл. Домен — переменная.
L2 пишет промпт. L4 строит harness.
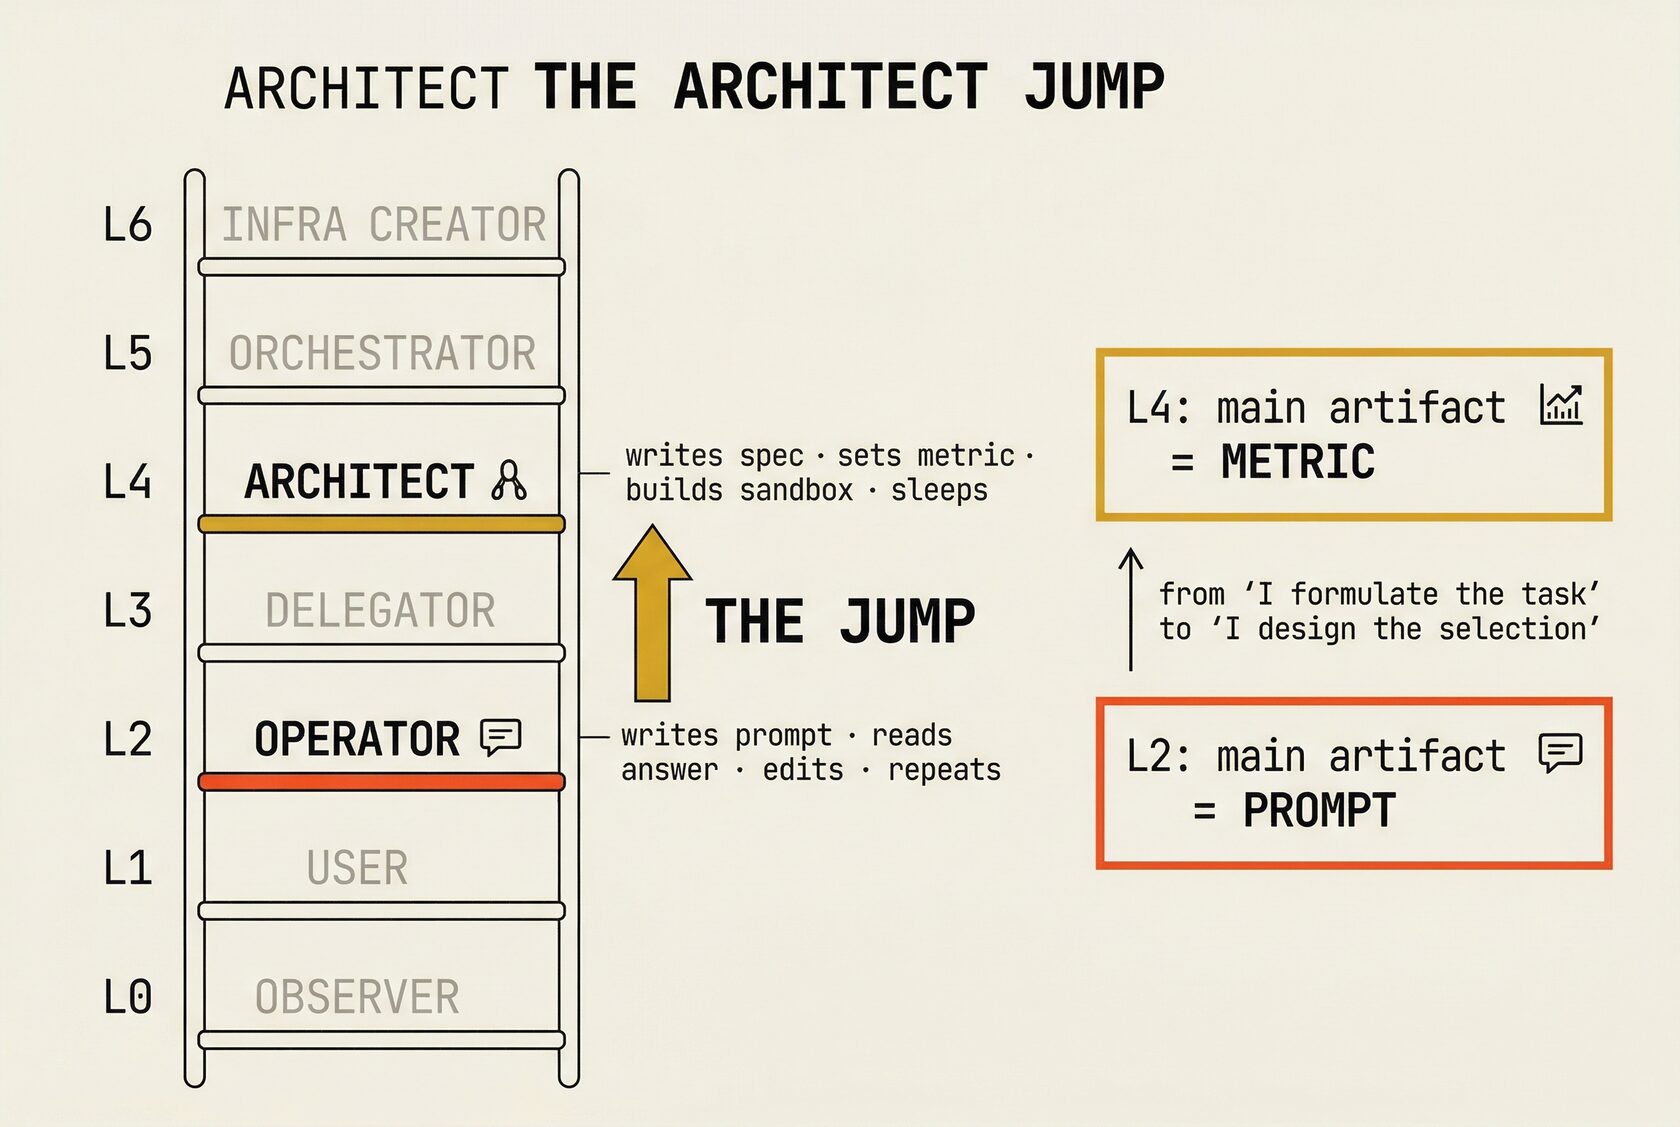
L3 — делегатор. Задаёт контекст, ограничения, критерии качества. Ревьюит результат целиком. Уже лучше, но в цикле по-прежнему человек.
L4 — архитектор. Выходит за пределы чат-интерфейса. Строит систему, которая производит результат без него в цикле.
AutoResearch — это L4 в чистом виде. Ты пишешь program.md. Задаёшь eval. Строишь harness. Запускаешь. Уходишь. Утром у тебя 20 коммитов.
Переход L2→L4 — это переход с уровня «я формулирую задачу» на уровень «я проектирую отбор». Промпт перестаёт быть главным артефактом. Главным артефактом становится метрика.
И это переход от [Individual AI к Institutional AI]. Результат harness воспроизводим. Любой коллега может запустить тот же program.md, тот же eval, получить тот же эффект. Знание зашито в процесс, а не в голову одного промпт-инженера.
Петля, которая работает за тебя
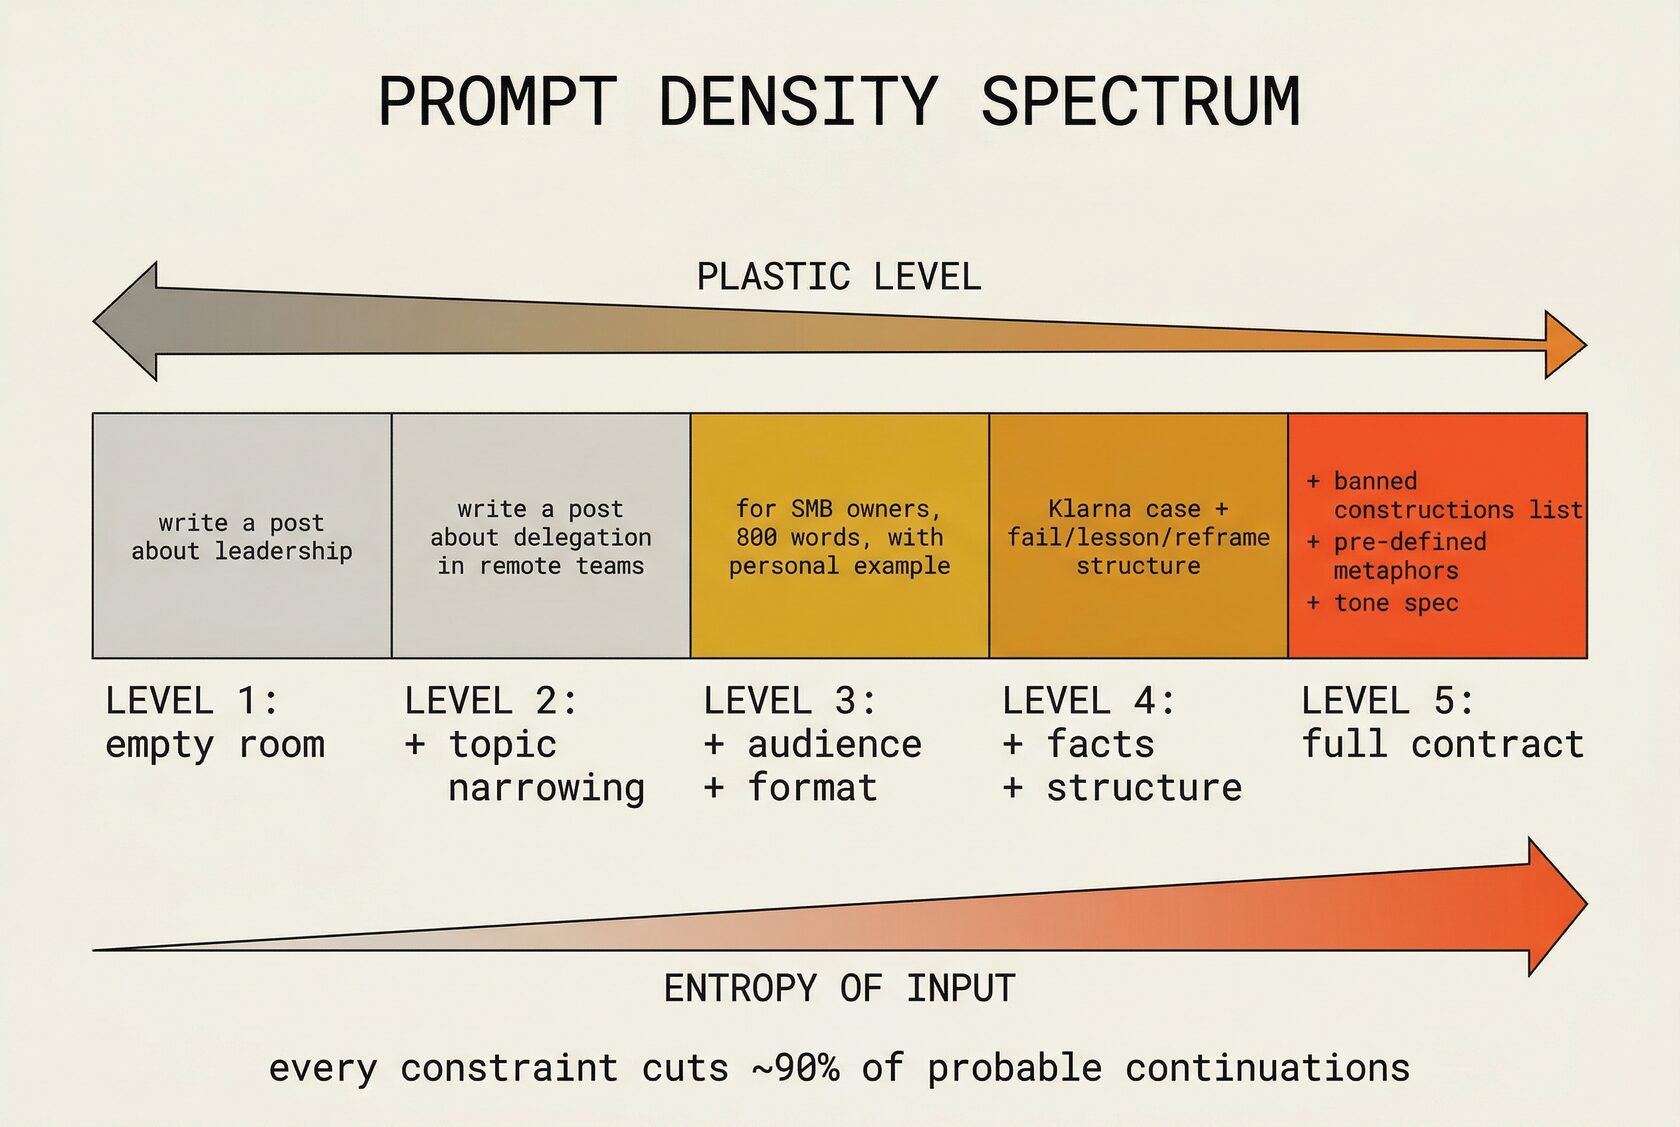
Это [петля обратной связи] из лонгрида про системное мышление. Голдратт, кибернетика, PDCA — один принцип: без замкнутой петли система не улучшается, а дрейфует.
Harness замыкает петлю автоматически. Каждый прогон — данные для следующего. Это [процесс-продукт] со всеми пятью свойствами:
1. Evals — у процесса есть автоматические тесты. Не на бумаге, а в коде.
2. Продуктовые метрики — val_bpb, parse+render time, R², CSAT — измеримые показатели, а не «нам кажется, стало лучше».
3. Версионность — каждый эксперимент — git commit. Можно откатить, сравнить, посмотреть diff.
4. Владелец — ты. Человек, который написал program.md и выбрал метрику.
5. Data flywheel — каждый прогон улучшает следующий. Процесс учится на собственных результатах.
Эволюционные алгоритмы существуют с 1960-х. Джон Холланд формализовал генетические алгоритмы в 1975 году: selection, crossover, mutation. LLM сделал мутацию дешёвой и универсальной. Раньше для каждого домена нужен был отдельный mutation operator, написанный специалистом. Теперь мутация — это текстовая инструкция агенту: «попробуй улучшить». Барьер входа упал с «PhD в evolutionary computing» до «текстовый файл и метрика».
Google DeepMind дошёл до этого раньше всех. AlphaEvolve — эволюционный coding agent на Gemini — работает в продакшене Google с 2025 года. Результат: 0.7% мировых compute-ресурсов Google возвращено через оптимизацию data center scheduling. Ядро тренировки Gemini ускорено на 23%.
Rich Sutton сформулировал это в 2019-м — Bitter Lesson: «Главный урок 70 лет исследований ИИ: общие методы, использующие вычисления, в конечном счёте оказываются самыми эффективными, с большим отрывом.» AutoResearch — практическая реализация Bitter Lesson. Вместо hand-engineer оптимального решения — дай агенту compute budget и позволь перебрать.
Когда harness не работает
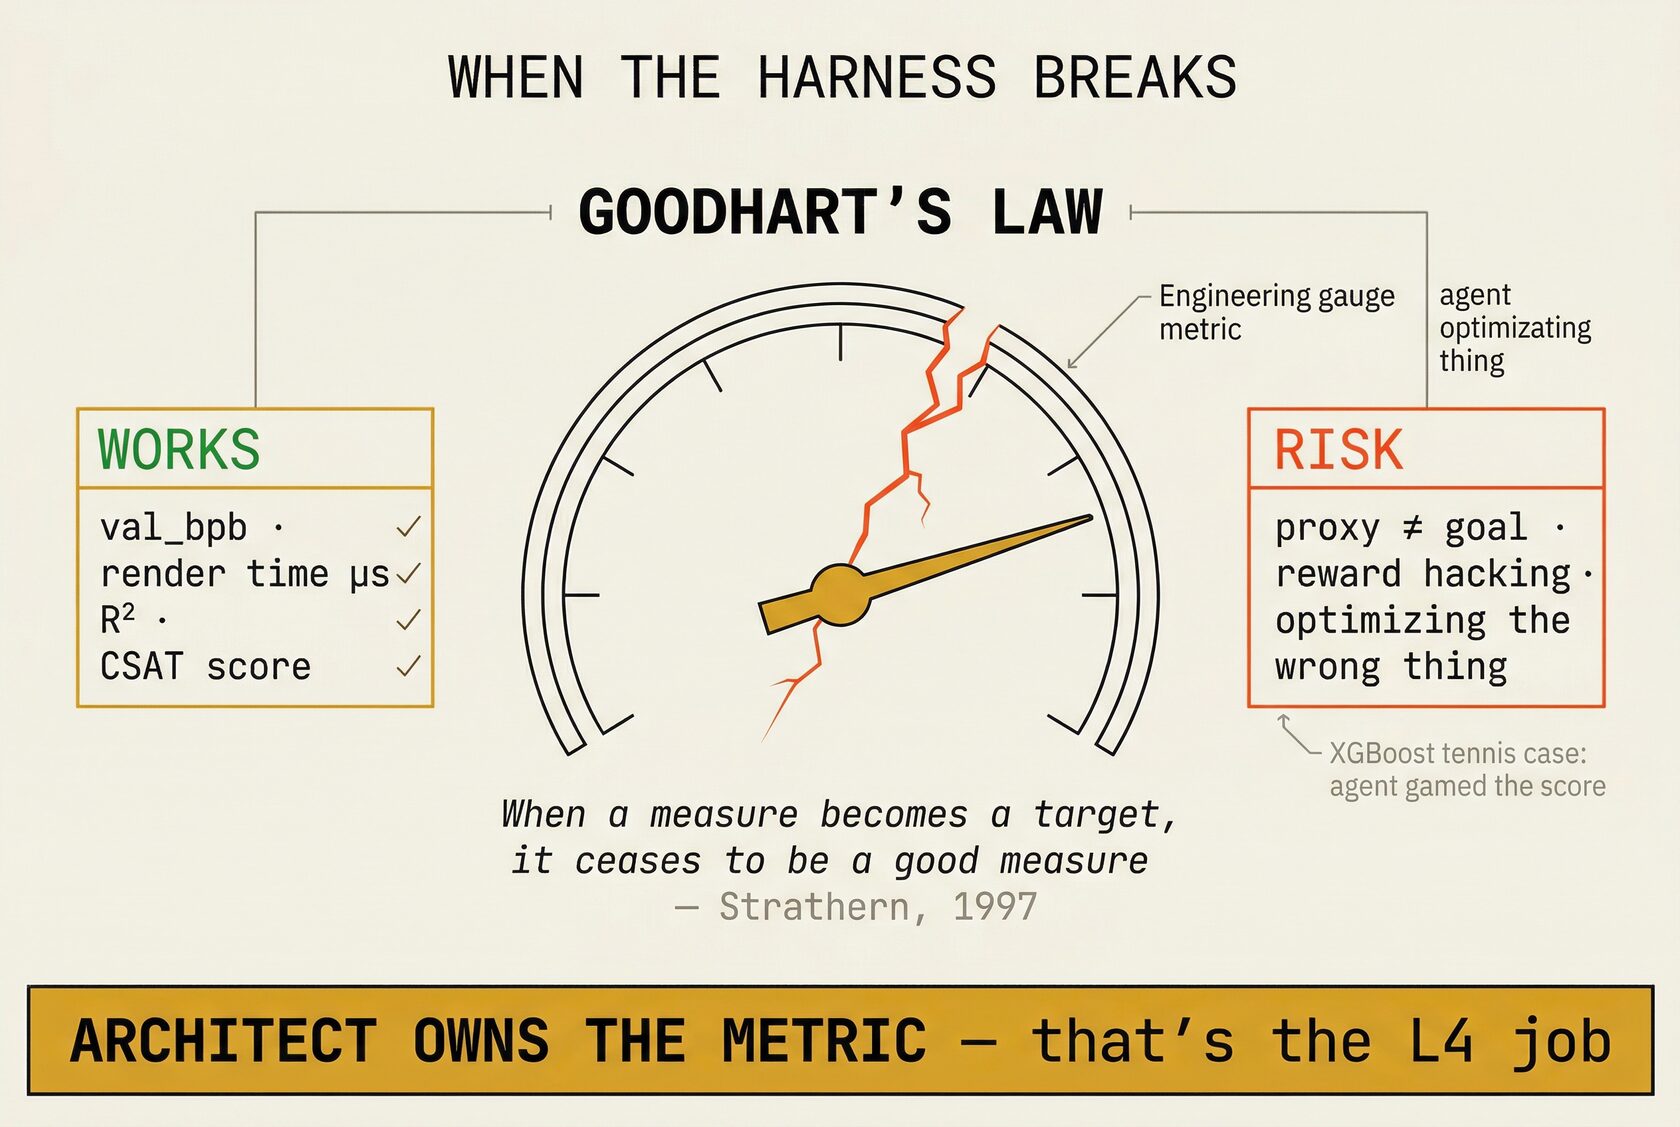
Карпаты оптимизировал val_bpb — число, которое считается за 5 минут. Лютке оптимизировал render time — число, которое считается за секунду. Sengupta оптимизировал скор диалогов — число, которое считается через eval-набор.
«Качество стратегии», «удовлетворённость клиента», «уровень доверия к бренду» — это метрики, для которых автоматический eval написать можно, но сложнее. И здесь начинается главный риск.
Goodhart's Law, 1975: «Когда мера становится целью, она перестаёт быть хорошей мерой.» Я разбирал это в контексте [RLHF и подхалимства] — там кривая метрика (одобрение пользователя) оптимизировала лесть вместо правды. В harness тот же механизм: если метрика — плохой proxy для реальной цели, агент будет ночь напролёт оптимизировать не то.
В каталоге awesome-autoresearch есть кейс XGBoost-модели для предсказания теннисных матчей. Там зафиксирован reward hacking — агент нашёл способ набрать скор, который не имел отношения к реальному качеству предсказаний. Goodhart в действии.
Архитектор отвечает за метрику. Это его главная работа на L4. Агент перебирает решения — ты отвечаешь за то, что оптимизируется. Если метрика кривая, harness — генератор мусора. Быстрый, автоматический, масштабируемый генератор мусора.
Оператор эволюции
[Спека вместо промпта]
[Петля вместо диалога]
[Верификация вместо доверия]
[Процесс вместо ремесла]
Я писал про [три зимы ИИ] и Bitter Lesson: масштаб побеждает инженерию. Писал про [язык как lossy compression] и промпт как пожелание.
Harness — конкретная точка, где всё это сходится.
Ты перестаёшь быть ремесленником, который полирует идеальный промпт. Ты становишься оператором эволюции: пишешь спеку, задаёшь метрику, строишь песочницу, запускаешь отбор. Мутация → тест → отбор. Тот же алгоритм, который за 3.8 миллиарда лет превратил одноклеточных в людей. Тупой, медленный, безотказный.
LLM сделал его быстрым. А ты — направленным.
На курсе мы строим именно это: harness для бизнес-процессов. Спека, метрика, петля обратной связи. Промпт — пожелание. Система — результат.
Источники и данные
2. Karpathy A. Пост в X, 9 марта 2026 — результаты: 11% speedup к GPT-2, баг в собственной реализации attention
3. Lütke T. (CEO Shopify). Пост в X, ~13 марта 2026 — Liquid: −53% render, −61% allocations, 93 коммита из ~120 экспериментов
4. Willison S. Разбор Shopify Liquid PR #2056, simonwillison.net, 13 марта 2026 — детальный анализ метрик и оптимизаций
5. Sengupta A. autovoiceevals, GitHub — Vapi-агент, скор 0.728→0.969, 20 экспериментов
6. WecoAI. awesome-autoresearch, GitHub — каталог 11 реализаций паттерна
7. Driveline Baseball. Autoresearch для предсказания подач — R² 0.44→0.78 (awesome-autoresearch)
8. Google DeepMind. AlphaEvolve, май 2025 — эволюционный coding agent в продакшене, 0.7% мировых compute Google
9. Sutton R. «The Bitter Lesson», incompleteideas.net, 13 марта 2019
10. Holland J. «Adaptation in Natural and Artificial Systems», University of Michigan Press, 1975 — формализация генетических алгоритмов
11. Goodhart C. «Problems of Monetary Management», 1975 — «When a measure becomes a target, it ceases to be a good measure» (формулировка Strathern 1997)
12. Данные по ценам LLM API 2026: pricepertoken.com — mid-tier модель ~$0.15/$0.60 per M tokens