
Скачок не произошёл.
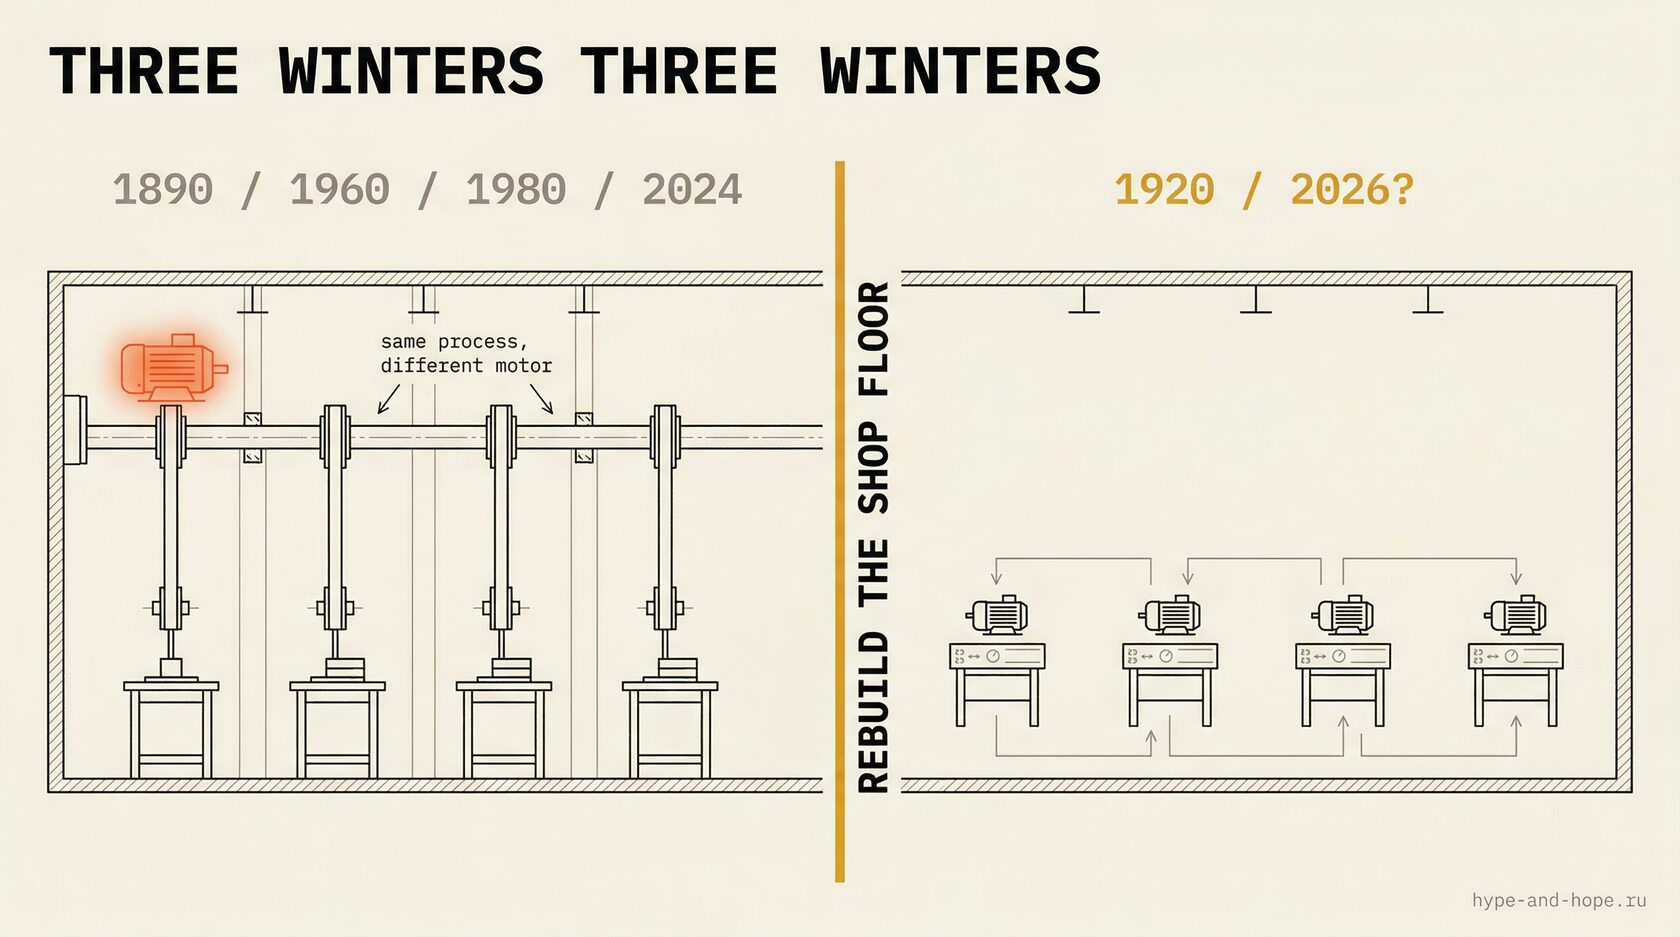
Экономист Пол Дэвид из Стэнфорда в 1990 году разобрал, почему. Фабрики заменили источник энергии, но сохранили старую компоновку цехов. А компоновка была подчинена физике парового привода: центральный вал под потолком, от него — ремни и шкивы к каждому станку. Электромотор стоял ровно на том же месте, что и паровая машина. Станки не двигались. Процесс не менялся. Мотор другой — цех тот же.
Производительность труда росла на 1.3% в год. Тридцать лет. Пока новое поколение инженеров не начало строить фабрики заново — вокруг логики электричества, а не пара. Индивидуальные моторы в каждом станке. Расстановка по потоку материала. Одноэтажные цеха вместо многоэтажных. И тогда рост прыгнул до 5.4% в год.
Между установкой мотора и перестройкой цеха прошло сорок лет.
Я рассказываю это, потому что с ИИ происходит то же самое. Уже в третий раз. Каждый раз — новый «мотор». Каждый раз бизнес ставит его в старый цех. Каждый раз наступает зима.
Давайте пройдём по всем трём.
Дартмут, 1956: «Мы решим это за лето»
Цитата из заявки, дословно:
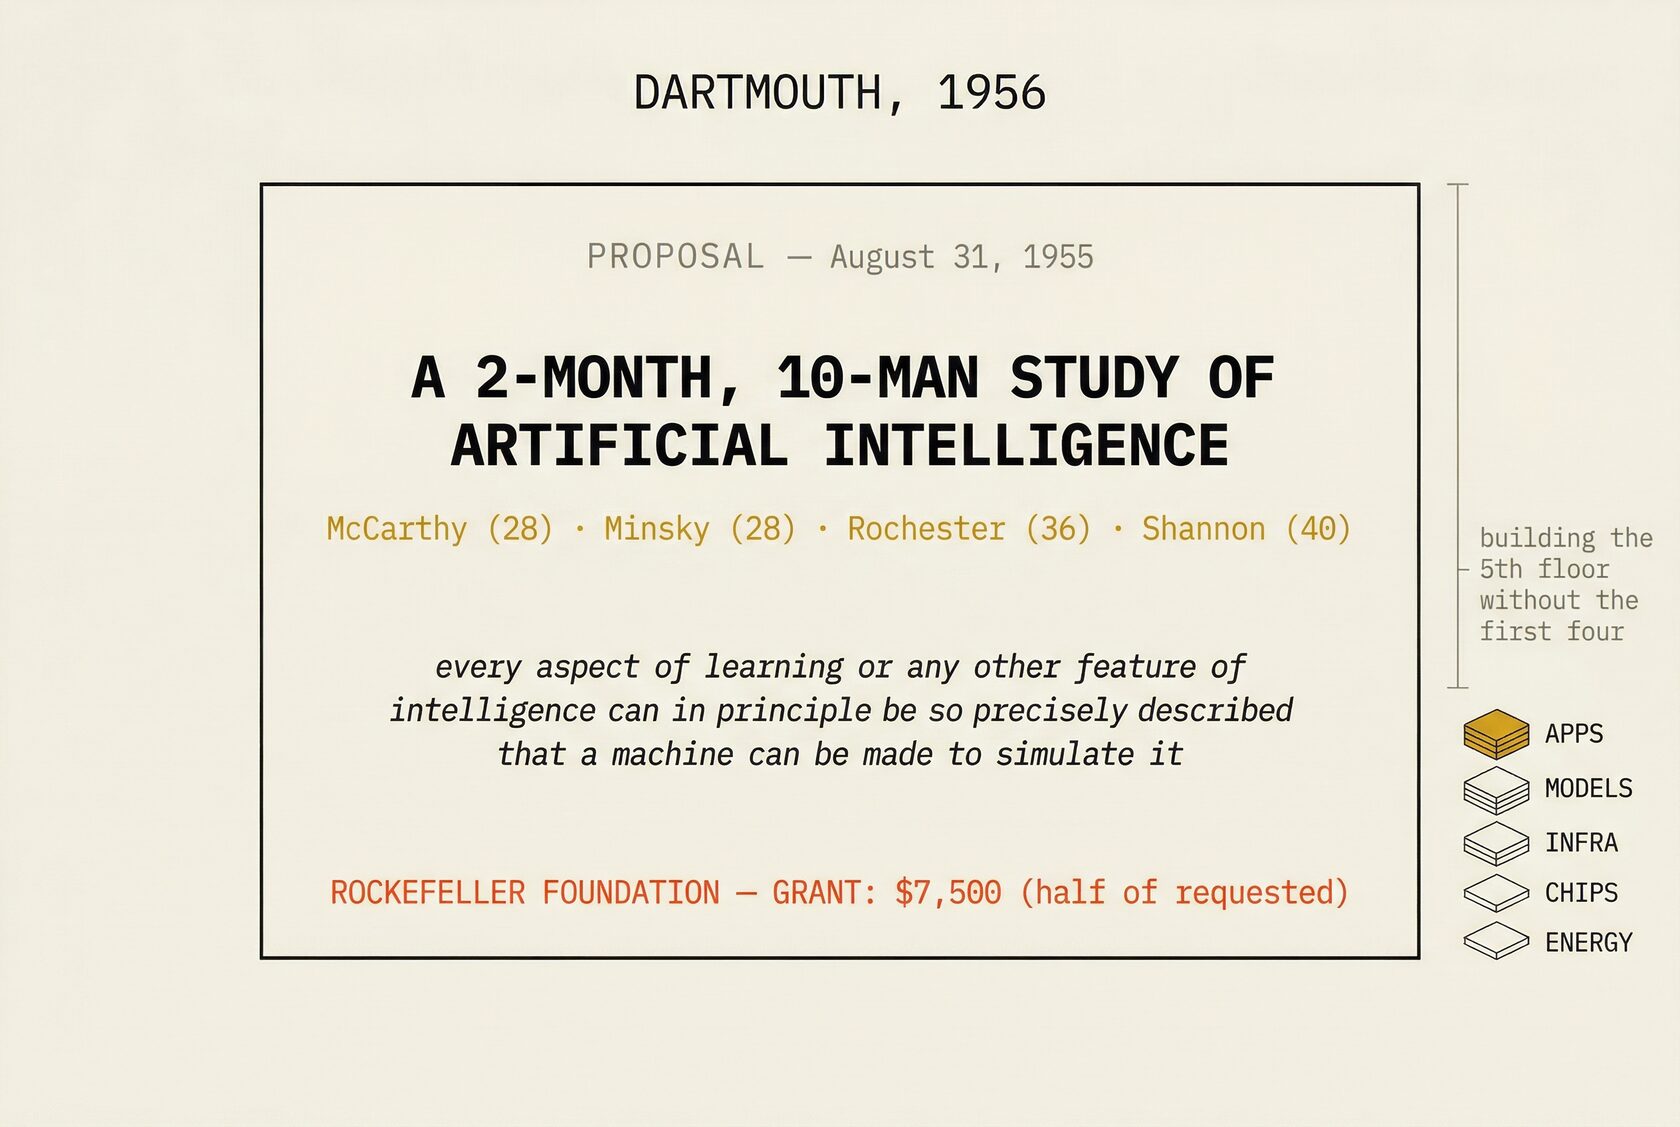
> «Мы предлагаем провести двухмесячное исследование искусственного интеллекта силами десяти человек летом 1956 года. Исследование основано на предположении, что каждый аспект обучения или любую другую особенность интеллекта можно в принципе описать настолько точно, что машина сможет это воспроизвести.»
Rockefeller Foundation дал $7,500 — половину запрошенного. Воркшоп длился пять-шесть недель.
Эти люди были гениями. Шеннон изобрёл теорию информации. Маккарти позже придумал термин «artificial intelligence» и язык LISP. Минский стал одним из главных теоретиков AI XX века.
И они ошиблись. Фундаментально.
Они верили, что интеллект — это логика. Логику можно формализовать в правила. Правила можно запрограммировать. И через поколение машины будут думать.
Если смотреть через [пятислойную модель ИИ-отрасли], они пытались строить сразу на уровне моделей и приложений — без фундамента. Ни вычислительной мощности (один компьютер занимал этаж здания и стоил миллионы). Ни данных (интернета не будет ещё сорок лет). Ни инфраструктуры для масштабирования. Пятый этаж без первых четырёх.
Уверенность ≠ правота. Даже если уверены гении.
Первая зима: Лайтхилл и конец иллюзий
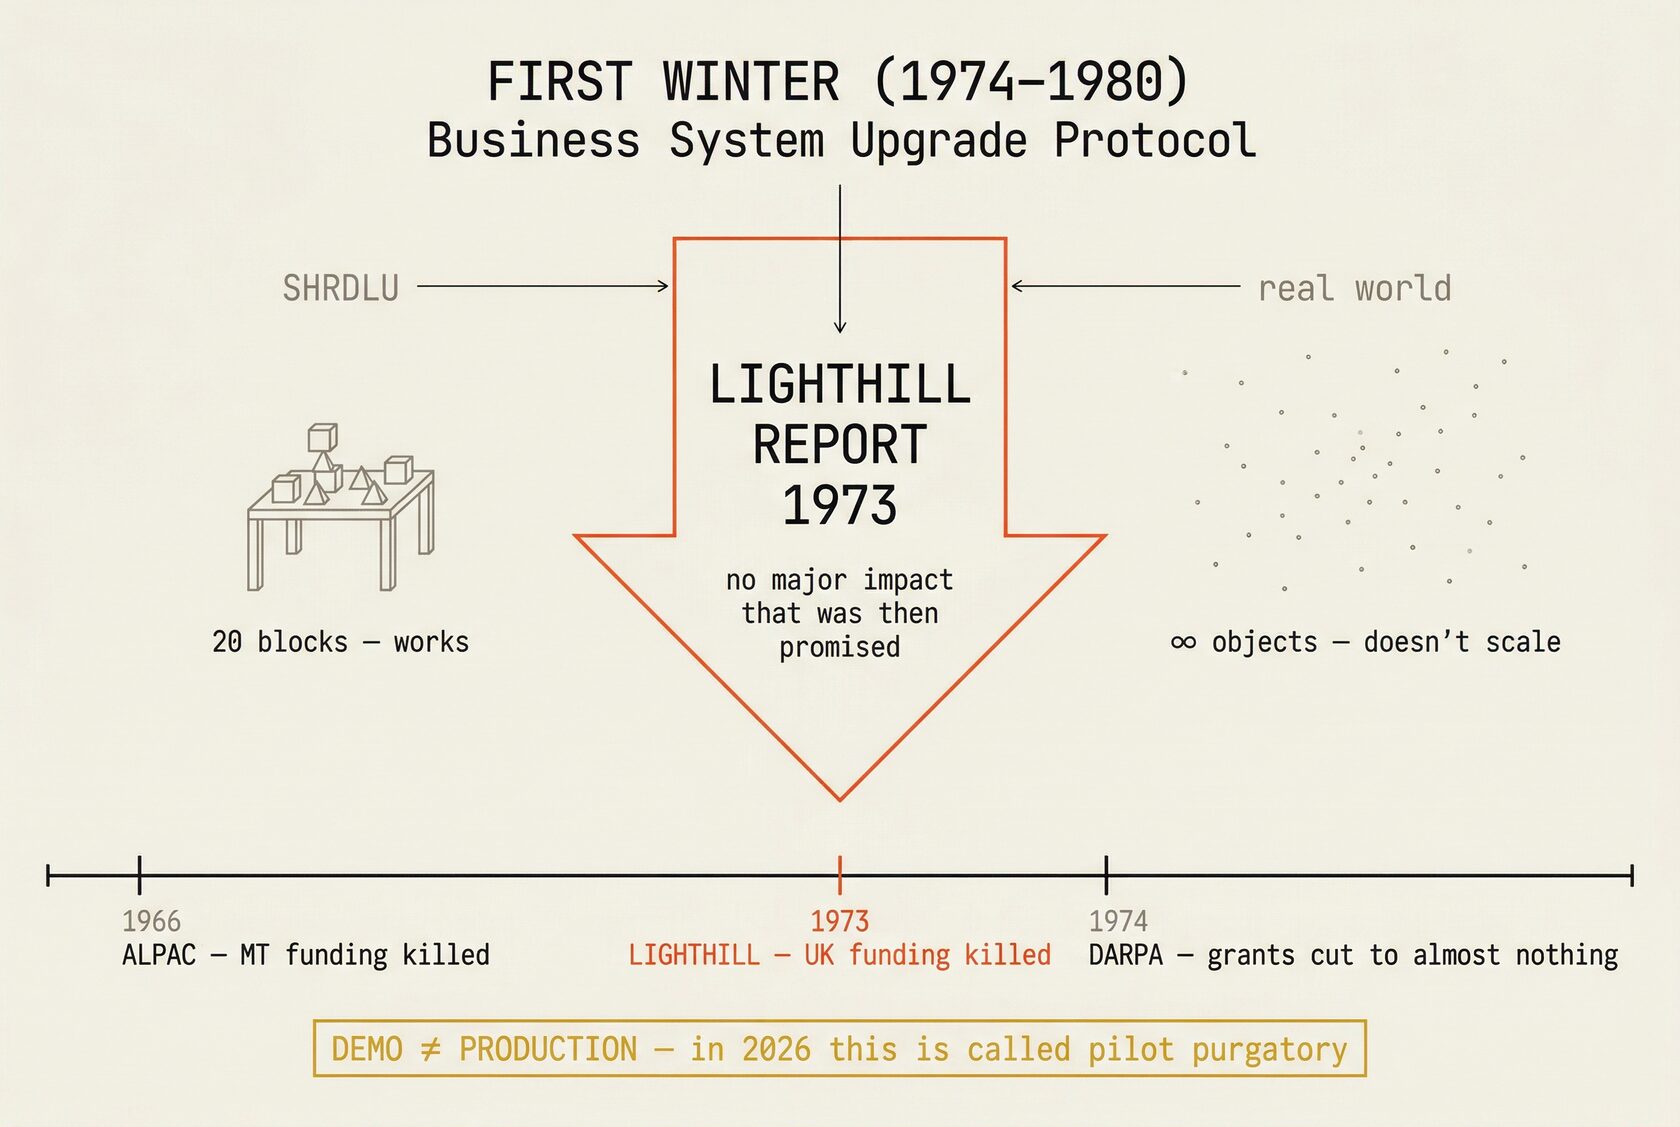
В 1966 году комитет ALPAC подвёл черту по машинному переводу: «У нас нет полезного машинного перевода, и нет ближайших перспектив его получить.» Финансирование MT в США заморозили на двадцать лет.
В 1973 году сэр Джеймс Лайтхилл, математик, по заказу британского Science Research Council написал отчёт, который стал приговором целому поколению. Ключевая фраза: «Ни в одной части этой области сделанные открытия не произвели того значительного эффекта, который тогда обещали.»
Лайтхилл точно назвал проблему: combinatorial explosion. Техники, которые работали на игрушечных задачах, не масштабировались на реальные. Двадцать кубиков SHRDLU — это лабораторная демо. Реальный мир — миллиарды объектов. Между демо и продом — пропасть.
DARPA обрезала гранты. Hans Moravec вспоминал: «Некоторым из этих людей решили преподать урок, срезав контракты на два миллиона долларов в год почти до нуля.»
Зима. Первая.
Если перевести на язык [эволюции компаний]: технология не добралась даже до уровня C1 — витринного использования в бизнесе. Она застряла в лаборатории. Мотор даже не поставили — показали макет и пообещали, что он потянет фабрику.
В 2026 году этот разрыв между демо и продом никуда не делся. Он просто переименовался в pilot purgatory.
Экспертные системы: блестящий C2
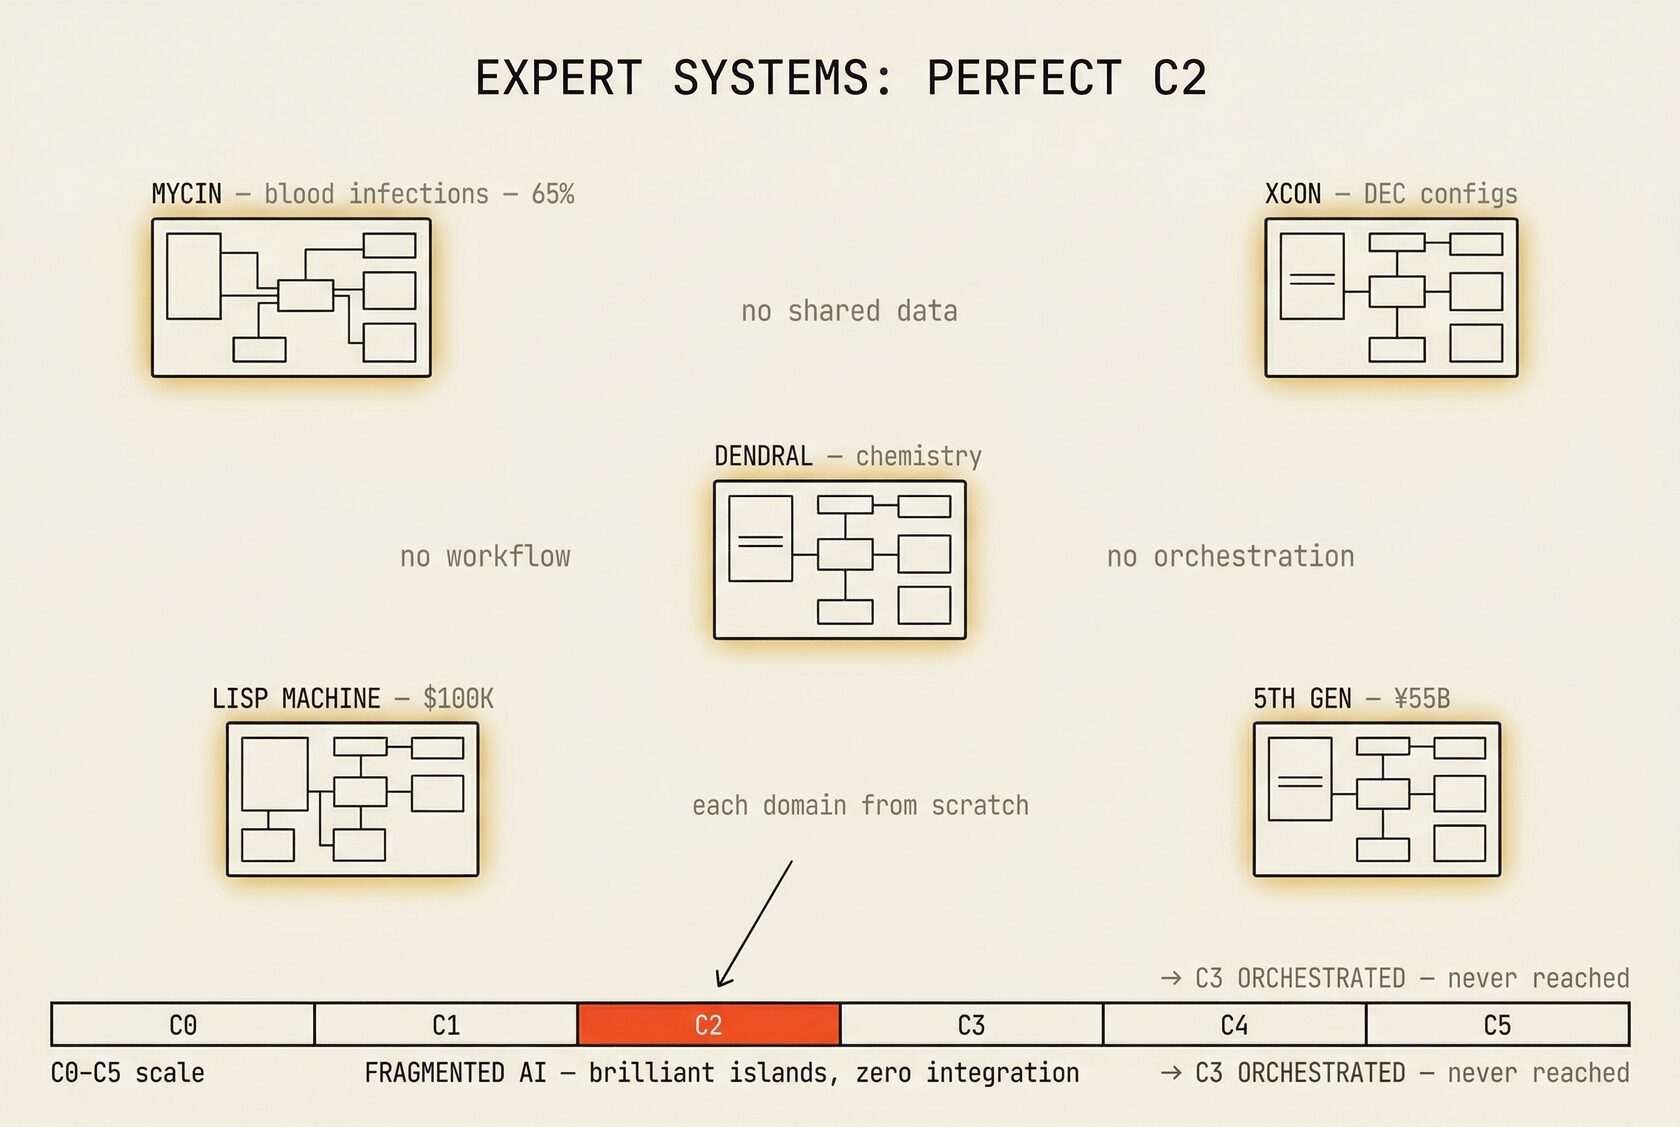
MYCIN, разработанная в Стэнфорде, диагностировала бактериальные инфекции крови по ~500 правилам. В формальной оценке показала точность около 65% — против 42–62% у преподавателей-медиков. Лучше большинства врачей. Работало.
Бизнес бросился вкладывать. К 1985 году корпорации тратили больше миллиарда долларов в год на AI-отделы. Symbolics продавала специализированные LISP-машины по $100K за штуку — и рынок этого оборудования дорос до $500M.
Японское правительство запустило проект «Пятого поколения» — параллельные inference-машины на логическом программировании. Бюджет: порядка 55 миллиардов йен (~$320M). План на десять лет.
К 1987 году стало ясно: каждая экспертная система работала в своём домене и не связывалась с другой. Правила были хрупкими — малейшее изменение контекста ломало всю логику. Масштабирование невозможно. Каждый новый домен — с нуля.
А потом десктопы Apple и IBM стали достаточно мощными, чтобы запускать rule-based движки дёшево. $500-миллионный рынок LISP-машин схлопнулся за один год. Symbolics обанкротилась в 1993-м. Японский проект закрылся без коммерческих результатов. Вторая зима.
Через призму [C0–C5] экспертные системы — это C2 в чистом виде. Фрагментированный ИИ. Блестящие изолированные решения без оркестрации. MYCIN работала для инфекций крови, но не разговаривала с системой назначения лекарств, страховой базой, расписанием врачей. Каждая система — остров. Между островами — ручной труд.
Знакомо? Если у вас в компании один отдел использует ChatGPT для текстов, другой — Copilot для кода, третий — AI-ассистента для писем, и между ними нет ни общих данных, ни workflow, ни метрик — поздравляю. Вы на уровне Symbolics 1985 года. Мотор другой, цех тот же.
MYCIN никогда не была внедрена в клиническую практику. Точность была достаточной. Процесса вокруг неё — не было.
- Кто несёт юридическую ответственность за диагноз машины?
- Как встроить её в расписание врача?
- Кто обновляет правила, когда меняются протоколы лечения? Этих вопросов никто не задал. Опять [мотор без перестройки цеха].
Тихий поворот: двадцать лет на периферии

Три исследователя — Джеффри Хинтон, Ян ЛеКун, Йошуа Бенжио — работали над идеей, которую мейнстрим списал. Нейронные сети. Обучение на данных вместо программирования правил.
Хинтон в 1986 году опубликовал ключевую работу по backpropagation. ЛеКун в 1989-м научил свёрточную нейросеть читать рукописные почтовые индексы в Bell Labs — и банки реально использовали его LeNet для проверки чеков в 1990-х. Бенжио строил нейронные языковые модели через 1990-е и 2000-е.
Академическое сообщество считало их маргиналами. Доминирующая парадигма — support vector machines и hand-crafted features. Статьи по нейросетям отклоняли с конференций. Хинтон позже описывал это: «lunatic fringe» — сумасшедшая периферия. ACM зафиксировала: «среди малой группы, которая оставалась приверженной» нейросетям.
Тридцать лет. Без денег, без внимания, без признания.
А потом произошли две вещи одновременно. Интернет дал данные. GPU дали вычисления. И в 2012 году Алекс Крижевский, Илья Суцкевер и Хинтон выставили на конкурс ImageNet свою нейросеть AlexNet. Top-5 error rate: **15.3%**. У runner-up — **26.2%**. Разрыв в 10.8 процентных пунктов при обычных улучшениях 1–2 п.п. в год.
Академия не оправилась. После AlexNet каждый участник ImageNet переключился на глубокие нейросети. Google в 2013-м купил стартап Хинтона. Суцкевер стал сооснователем OpenAI.
В 2019 году Ричард Саттон написал эссе «The Bitter Lesson» — горький урок. Точная цитата: «Главный урок из 70 лет исследований ИИ: общие методы, использующие вычисления, в конечном счёте оказываются наиболее эффективными, и с большим отрывом.»
Нюанс, который часто пропускают: Саттон не говорит «просто добавь compute». Он говорит, что два метода, масштабируемые бесконечно — search и learning — побеждают любую ручную инженерию. Не вычисления сами по себе, а мета-методы, которые используют вычисления.
В терминах [пяти слоёв отрасли]: впервые нижние этажи — энергия, чипы, инфраструктура — доросли до верхних. Фундамент под пятым этажом наконец появился.
2012–2022: десять лет ускорения
В 2017-м восемь инженеров Google опубликовали «Attention Is All You Need» — архитектуру трансформеров. Статью процитировали больше 173,000 раз. Она решила конкретную инженерную проблему: до трансформеров рекуррентные сети обрабатывали слова по одному, последовательно. Параллелизовать нельзя. Трансформер заменил рекуррентность механизмом self-attention — каждое слово «видит» каждое другое одновременно. Обучение стало параллелизуемым на GPU. Больше железа = пропорционально лучше результат. Конкретный пример из той же статьи: обучение на английско-немецком переводе заняло 12 часов на 8 GPU. Сопоставимая RNN-модель требовала дни или недели.
Это открыло гонку масштабирования. И гонка очень быстро дала результат, которого никто не ждал.
В 2020-м OpenAI показала GPT-3: 175 миллиардов параметров (против 1.5 миллиарда у GPT-2 — стократный скачок). Стоимость обучения — около $4.6M только на compute. И тут произошла вещь, которую не предсказывала ни одна теория. GPT-3 умел то, чего в него никто не закладывал. Он писал работающий код. Переводил между языками. Решал задачи по двум-трём примерам в промпте, хотя его этому не учили. Emergence — способности, возникающие из масштаба. Количество переходит в качество, и ты не можешь предсказать, в какой момент.
Но GPT-3 был доступен только через API по инвайту. Без чат-интерфейса. Для использования нужны были навыки программирования. Цена: $0.06 за тысячу токенов. Это был инструмент для разработчиков — мощный, впечатляющий и абсолютно недоступный обычному человеку. [Individual AI] для узкой прослойки, и даже близко не Institutional.
Ноябрь 2022: четвёртая попытка
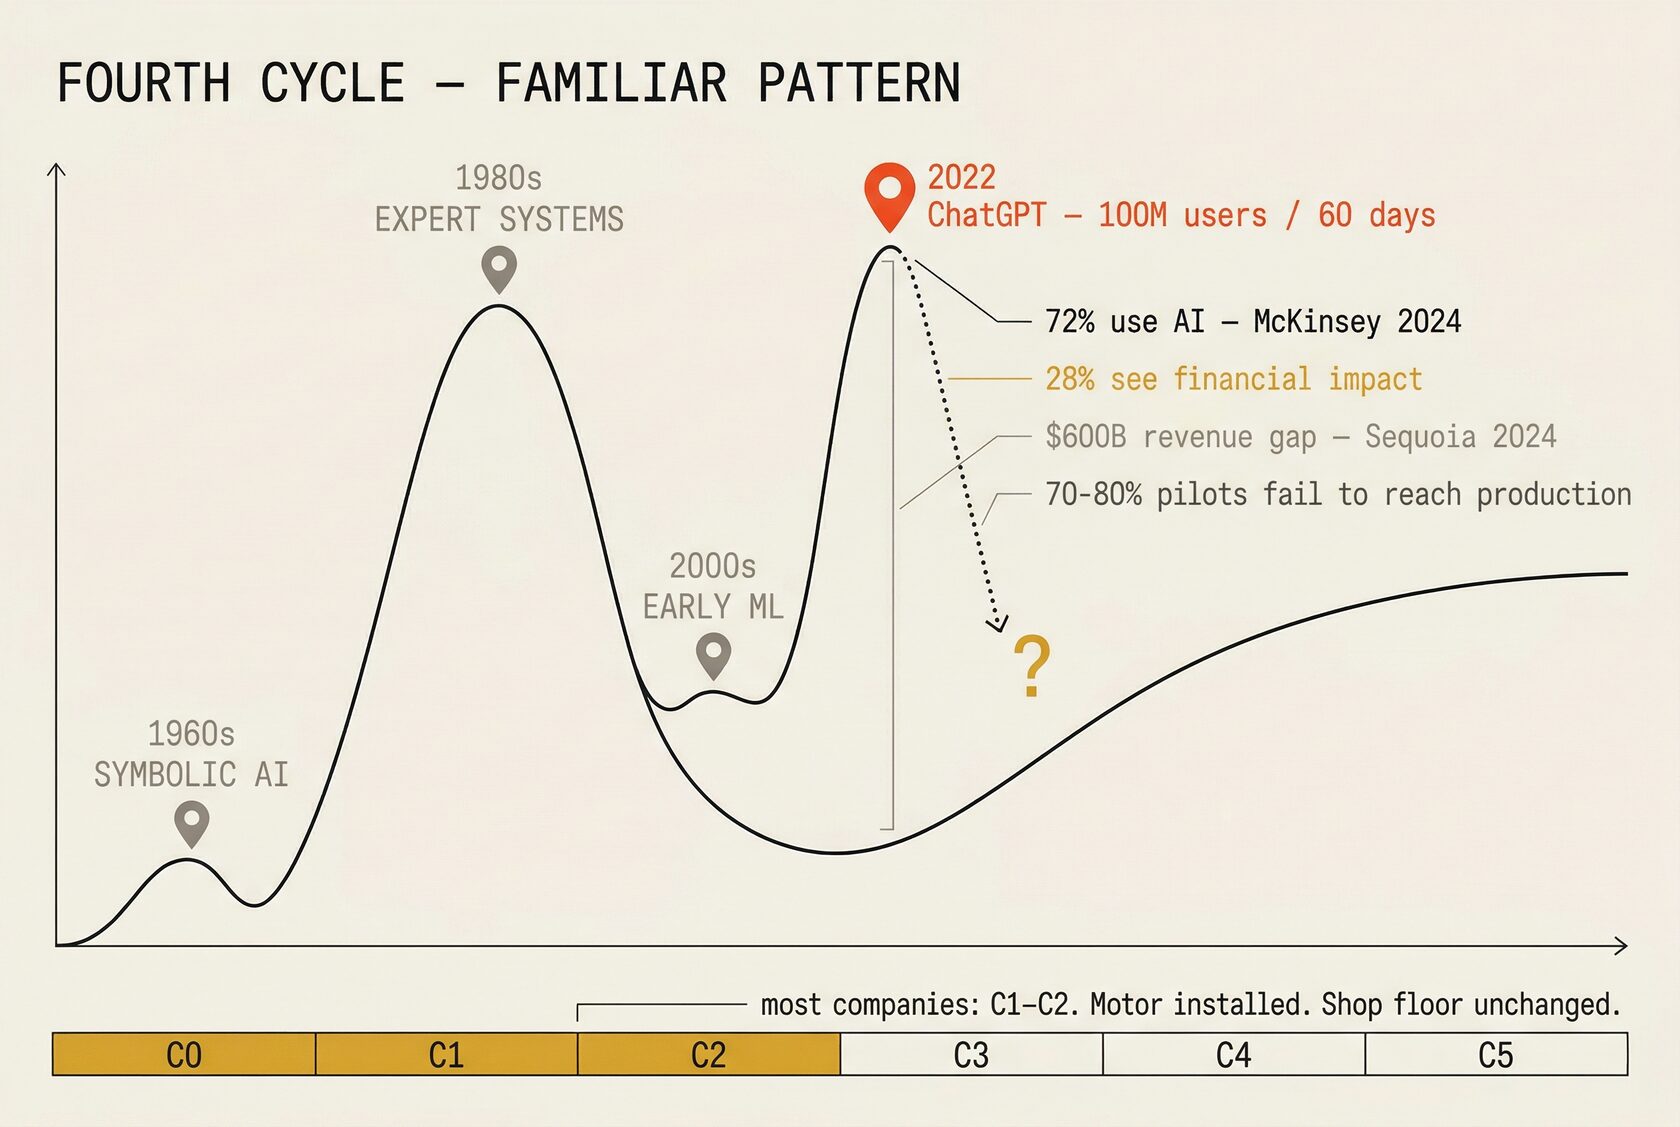
Миллион пользователей за пять дней. Сто миллионов за два месяца. Самое быстрорастущее потребительское приложение в истории. TikTok шёл к ста миллионам девять месяцев. Instagram — больше двух лет.
Технический прорыв между GPT-3 и ChatGPT был в трёх вещах. Первая — RLHF: метод, при котором модель на 1.3 миллиарда параметров (InstructGPT) стала предпочтительнее для людей, чем GPT-3 на 175 миллиардах - потому что слушает. Вторая — чат-интерфейс. Третья — бесплатность.
Это урок для любого бизнеса: прорывной продукт — часто не прорывная технология. Это момент, когда кто-то делает технологию используемой. Capability существовала два с половиной года. Не хватало упаковки.
И вот теперь — знакомый паттерн.
Корпорации бросились внедрять. Подписки на AI-инструменты, AI-чемпионы в каждом отделе, пилоты, хакатоны, «AI-стратегия» в каждом годовом отчёте. McKinsey в 2024-м зафиксировала: 72% организаций используют AI. При этом только 28% видят значимый финансовый эффект. Остальные 72 минус 28 — используют, но результата нет.
Sequoia Capital в июне 2024-го опубликовала анализ Дэвида Кана: Nvidia зарабатывает ~$300B в год на дата-центрах. Чтобы окупить эту инфраструктуру, конечные пользователи должны генерировать ~$600B AI-revenue. Фактический AI-revenue (без Nvidia и облачных провайдеров) — около $100B. Gap — полтриллиона долларов. Кан не назвал это пузырём. Он назвал это вопросом. Хороший вопрос.
70–80% AI-пилотов не доходят до продакшена — данные Everest Group и Bain. Я вижу это на каждом втором клиенте: провели воркшоп, запустили пилот, показали CEO красивый демо. CEO спрашивает: «А что с ROI?» Молчание. Пилот тихо умирает. Через полгода — новый воркшоп с новым инструментом.
Большинство компаний сидят на [C1–C2]: витринный и фрагментированный ИИ. Подписки есть. Пилоты есть. Перестроенных процессов — нет. Мотор стоит. Цех не перестроен.
Опять.
Что отличает четвёртую попытку от трёх предыдущих

Три отличия, и они существенные.
Первое. Впервые все [пять слоёв ИИ-отрасли] существуют одновременно. Энергия, чипы, инфраструктура, модели, приложения — весь стек работает и доступен. В 1960-х не было ни данных, ни вычислений. В 1980-х не было масштабируемой инфраструктуры. Сейчас — есть всё.
Второе. Впервые продукт дешёвый, массовый и встраиваемый. ChatGPT бесплатен. Claude, Gemini, Copilot — подписки по цене обеда. API стоит копейки. GitHub Copilot к началу 2025 — 1.8 миллиона платных подписчиков. Coding productivity +10–30% в контролируемых исследованиях. Это уже внутри рабочих процессов миллионов людей.
Третье — и главное. Впервые [процесс может стать продуктом]. До ИИ бизнес-процессы были fuzzy: описаны в Notion, живут в головах сотрудников, не тестируются, не версионируются, умирают вместе с уходом ключевого человека. Сейчас процесс можно превратить в исполняемый артефакт — agent graph, workflow, prompt + tools — с eval'ами, метриками, product owner'ом и data flywheel. Каждый обработанный тикет улучшает следующий. Каждый новый договор делает юридический процесс точнее. В 1960-х нечего было внедрять — технология жила в лабе. В 1980-х экспертные системы работали, но каждая — в изоляции, без оркестрации, без обратной связи. Сейчас впервые есть инструменты для перестройки цеха, а не только для замены мотора.
Вопрос: воспользуемся?
Три зимы учат одному.
Технология, которая работает в демо, и технология, которая работает в бизнесе — два разных явления. Первое даёт публикации и хайп. Второе даёт ценность. Между ними — процесс, инфраструктура, архитектура. Перестройка цеха.
Каждая зима убивала тех, кто ставил моторы. Выживали те, кто перестраивал цеха — или те, кто упрямо работал на периферии, как Хинтон тридцать лет. Зимы — фильтр, не приговор.
Сейчас четвёртая попытка. Впервые с полным стеком и дешёвым продуктом. И впервые с реальной возможностью превратить процессы в исполняемые, измеримые, улучшающиеся артефакты.
Ты ставишь мотор или перестраиваешь цех?
Я собрал [курс AI Architect], чтобы разобраться с этим вопросом на практике. Не «как лучше промптить» — промпт не перестраивает цех. А как выбрать сценарий, встроить ИИ в процесс, собрать workflow с метриками и evals, и сделать из этого то, что переживает hype-циклы. Зимы приходят. Процессы остаются.
Keep printing.
Источники и данные
- Paul A. David, "The Dynamo and the Computer: An Historical Perspective on the Modern Productivity Paradox", *American Economic Review*, Vol. 80, No. 2, May 1990 — рост производительности 1.3% → 5.4%, лаг ~40 лет
Дартмут и ранний ИИ
- Dartmouth Proposal, August 31, 1955 (McCarthy, Minsky, Rochester, Shannon) — оригинальный текст заявки — https://www-formal.stanford.edu/jmc/history/dartmouth/dartmouth.html
- Rockefeller Foundation, грант $7,500 — ретроспектива фонда
Первая зима
- ALPAC Report, 1966 — «нет полезного машинного перевода и нет ближайших перспектив»
- Sir James Lighthill, "Artificial Intelligence: A General Survey", UK Science Research Council, 1973 — «ни в одной части области обещания не были выполнены»
Экспертные системы и вторая зима
- MYCIN (Stanford, mid-1970s) — ~65% точность vs 42–62% у врачей-преподавателей. Shortliffe, 1976
- Symbolics — банкротство 1993, рынок LISP-машин ~$500M, схлопнулся к 1988
- Japanese Fifth Generation Computer Project (1982–1992) — бюджет ~55 млрд йен (~$320M), нет коммерческих результатов
Нейросети и «тихий поворот»
- Rumelhart, Hinton, Williams, "Learning representations by back-propagating errors", *Nature*, 1986
- LeCun et al., handwritten digit recognition at Bell Labs, 1989
- ACM A.M. Turing Award 2018 (Hinton, LeCun, Bengio) — «30 лет фундаментальной работы»
- Krizhevsky, Sutskever, Hinton, "ImageNet Classification with Deep Convolutional Neural Networks", 2012 — 15.3% vs 26.2% top-5 error rate
- Richard Sutton, "The Bitter Lesson", 2019 — «общие методы, использующие вычисления, наиболее эффективны, и с большим отрывом»
Трансформеры и GPT
- Vaswani et al., "Attention Is All You Need", 2017 — 173,000+ цитирований
- Brown et al., "Language Models are Few-Shot Learners" (GPT-3), 2020 — 175B параметров, ~$4.6M compute (Lambda estimate)
ChatGPT и текущий цикл
- ChatGPT launch: 30 November 2022. 1M users in 5 days, 100M MAU in ~60 days — UBS/Similarweb
- Ouyang et al., "Training language models to follow instructions with human feedback" (InstructGPT), 2022 — 1.3B InstructGPT preferred over 175B GPT-3
- McKinsey, "The state of AI in early 2024" (May 2024) — 72% organizations using AI, 28% significant financial impact
- David Cahn, Sequoia Capital, "AI's $600B Question", June 2024 — $600B revenue gap
- Everest Group, Bain & Company — 70–80% AI pilots fail to reach production
- GitHub Copilot: ~1.8M paid subscribers, early 2025
Авторские концепции
- [Структура ИИ-отрасли (5 слоёв)]
- [Эволюция компаний (C0–C5)]
- [Individual AI vs Institutional AI]
- [Процесс становится продуктом]