
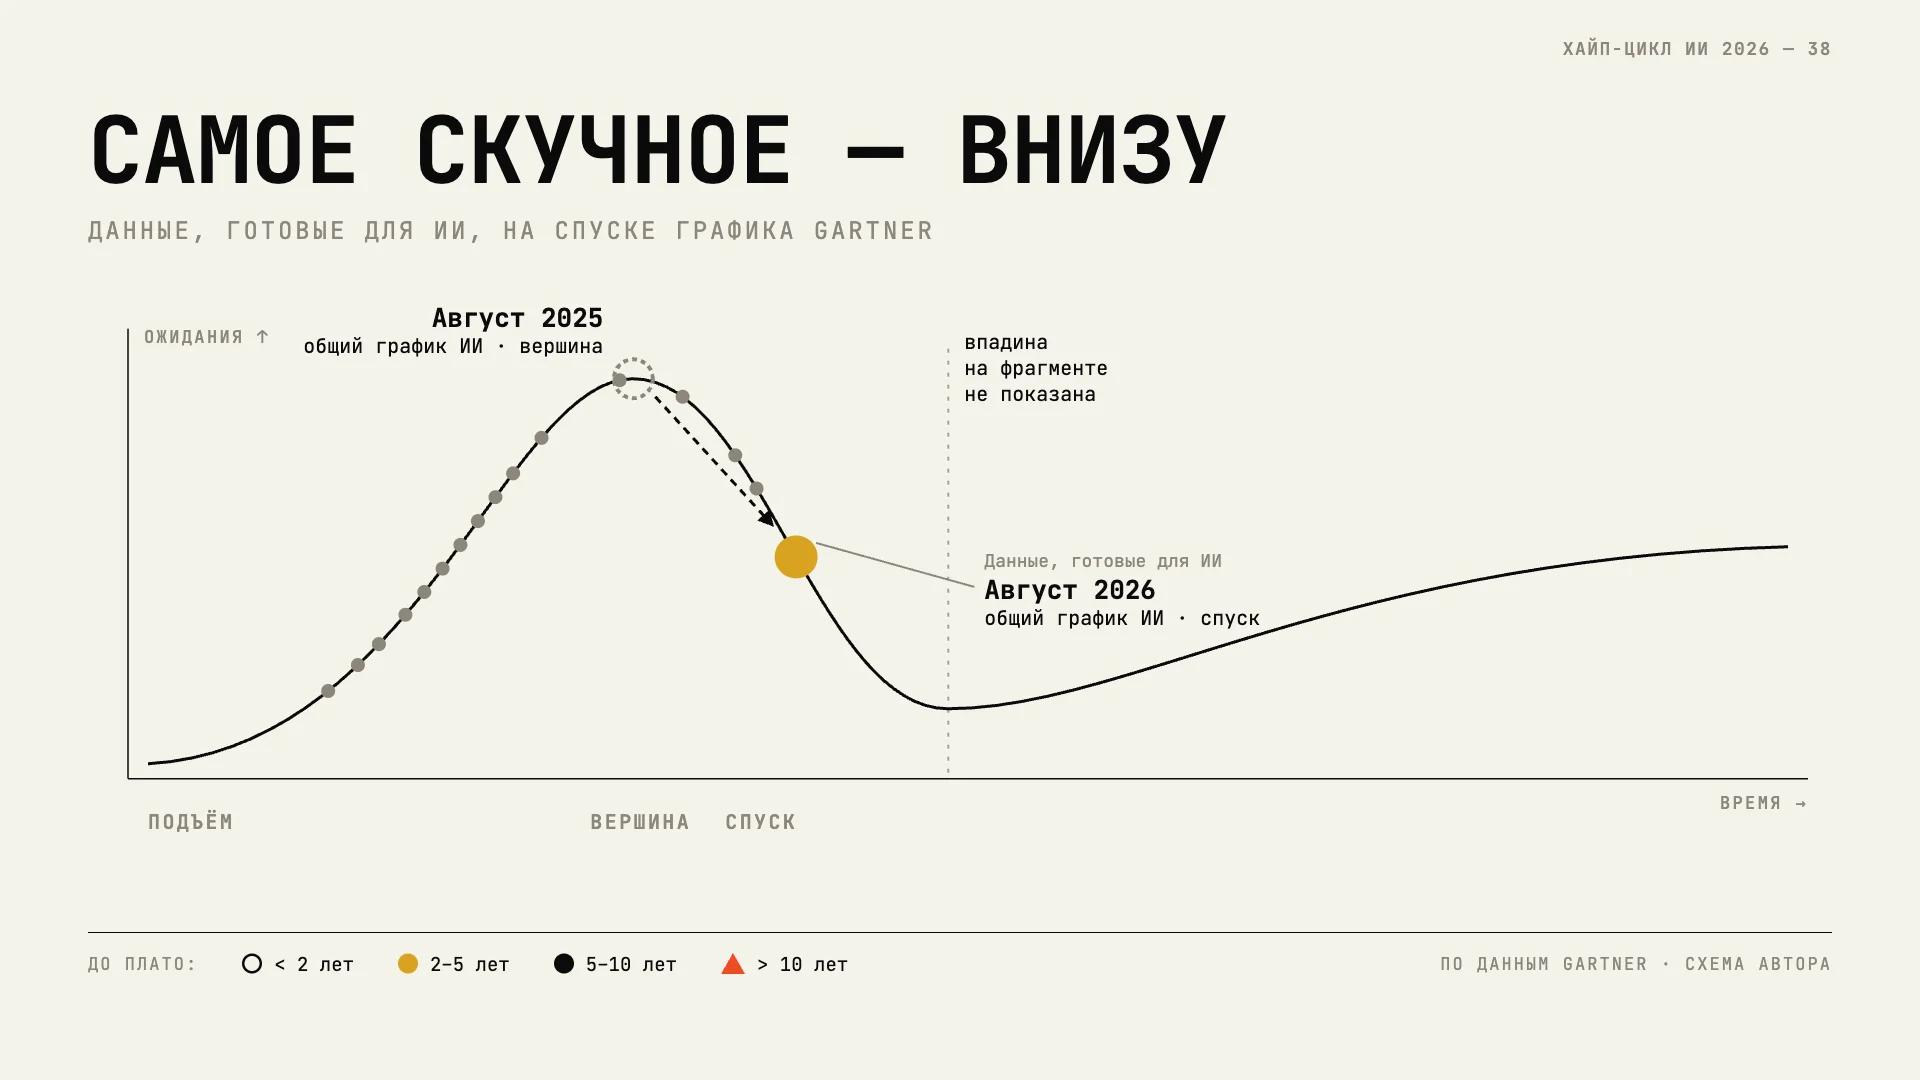
На графике Gartner, который пересылают в чатах, есть точка с названием AI-Ready Data. По-русски «данные, готовые для ИИ». Среди шестнадцати технологий она звучит скучнее всех: ни роботов, ни суверенитета, ни сверхразума. И стоит она ниже остальных, далеко по спуску, ближе ко дну.
Вопрос, который я за этим слышу, такой: почему именно данные разочаровывают сильнее всего и какое это имеет отношение ко мне, если я не директор по данным и у меня нет озера данных, а есть почта, диск и пара таблиц?
Ответ у меня получился в два слоя. Первый про то, что нарисовано и что Gartner об этом пишет. Второй про то, что из этого следует для небольшой компании и для одного человека, и этот слой уже моё мнение.
Как устроена кривая, я разбирал в статье «Кривая — не закон», шестнадцать технологий на ней в статье «Путеводитель по графику», а про агентов, которые идут по спуску рядом, в статье «Агенты катятся вниз». Источники те же: сам график и открытые статьи Gartner. Платный отчёт я не читал. Для этой темы добавил четыре внешних исследования, о них в четвёртом разделе.
1. Что нарисовано
В августе 2025 года Gartner выпустила пресс-релиз о том, какие технологии ИИ идут быстрее всего. Названы две: ИИ-агенты и данные, готовые для ИИ. Обе стояли на пике завышенных ожиданий. Релиз на сайте Gartner мне не открылся, я сверял его по перепечаткам, поэтому оговорка «в перепечатке» остаётся.
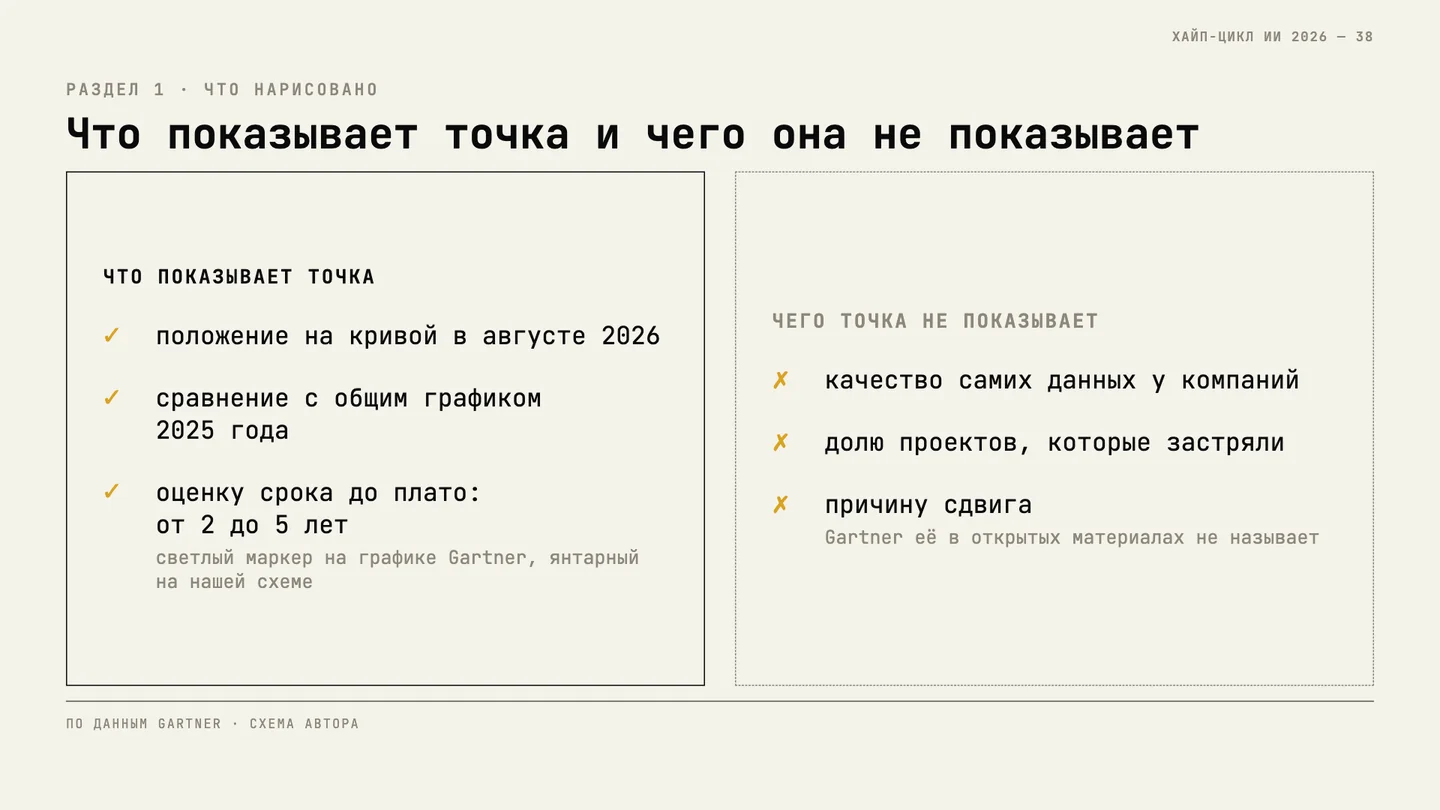
В августе 2026 года вышел новый общий график. Данные, готовые для ИИ, на нём лежат далеко по спуску, ниже агентов и ниже мультимодального ИИ. Маркер на графике Gartner светло-голубой (на наших схемах янтарный): до плато, по оценке Gartner, от двух до пяти лет. Это честное сравнение двух общих графиков одной серии: год назад на вершине, теперь на спуске.
Чего картинка не говорит. Во-первых, слова «разочаровывает сильнее всех» мои, а не Gartner. На графике стоит положение, и оно показывает, как меняются ожидания. Сколько разочарования у конкретных людей, оно не измеряет. Я использую выражение, потому что читатели спрашивают именно так, но держу в голове, что это перевод картинки на человеческий язык.
Во-вторых, на фрагменте, который у меня есть, впадины не видно. Данные пока на спуске, и впадины разочарования они, судя по картинке, ещё не достигли. Кривая Gartner не делает из этого вывода «дальше будет хуже» или «дальше выправится».
В-третьих, почему точка стоит именно здесь, Gartner в открытых материалах не объясняет. Всё, что дальше, я собираю из её цифр и из внешних исследований, и там, где это мои выводы, я так и пишу.
2. Что это вообще такое
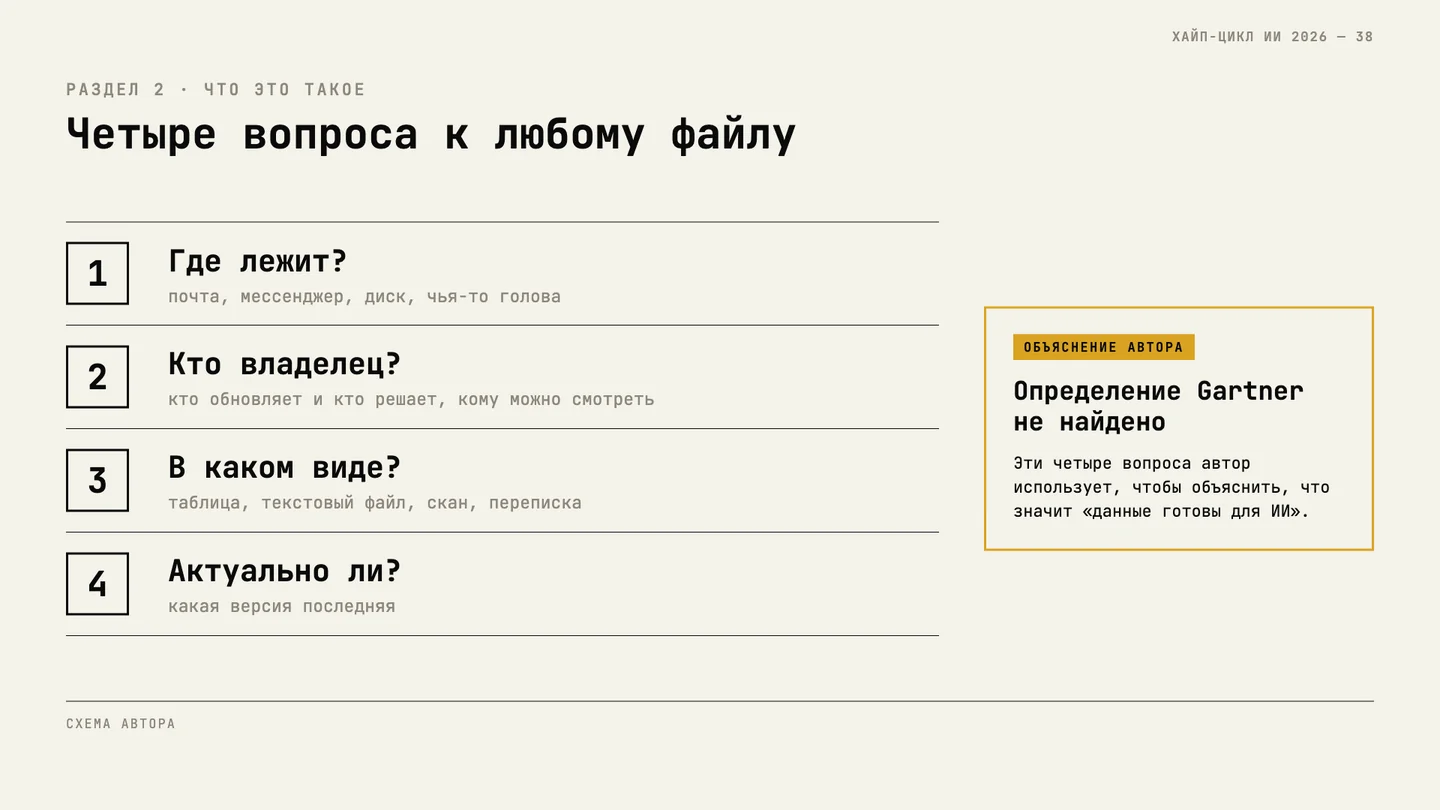
Официального определения от Gartner я не нашёл. По перепечатке релиза 2025 года, готовность данных к ИИ определяется только для конкретной задачи и конкретной техники ИИ. Мерить надо так: хватает ли этих данных для этой задачи. Общая «чистота» ни к чему не привязана. К этой мысли я вернусь в последнем разделе.
Теперь без терминов. К «большим данным» это отношения не имеет. Речь о том, можно ли положиться на то, из чего ИИ будет собирать ответ. Мне удобно разложить его на четыре части. Это моё объяснение, а не определение Gartner.
Где лежит. Прайс-лист живёт в таблице, условия скидок в переписке с клиентом, а последняя версия договора у юриста в мессенджере. ИИ видит только то, что ему показали.
Кто владелец. Кто обновляет документ и кто решает, что его можно показывать модели. Если ответа нет, то нет и человека, который скажет, что файл устарел.
В каком виде. Таблица читается легко. Скан договора без распознавания, фотография доски или переписка на сорок экранов читаются хуже, и ИИ может их понять по-своему.
Насколько свежее. Файл «прайс_финал_2» не говорит, чем он отличается от «прайс_финал_3».
Для человека, который сидит рядом с компанией много лет, всё это «и так понятно». Новому сотруднику не понятно, и модели тоже. Удобная картинка: ИИ приходит в вашу папку как новичок в первый рабочий день, без доступа к тому, что все остальные «просто знают».
3. Что говорит Gartner цифрами
В феврале 2025 года Gartner выпустила отдельный релиз на эту тему. Страница gartner.com у меня тоже не открылась (403), цифры я сверял по цитатам из релиза в выдаче. В нём две цифры.
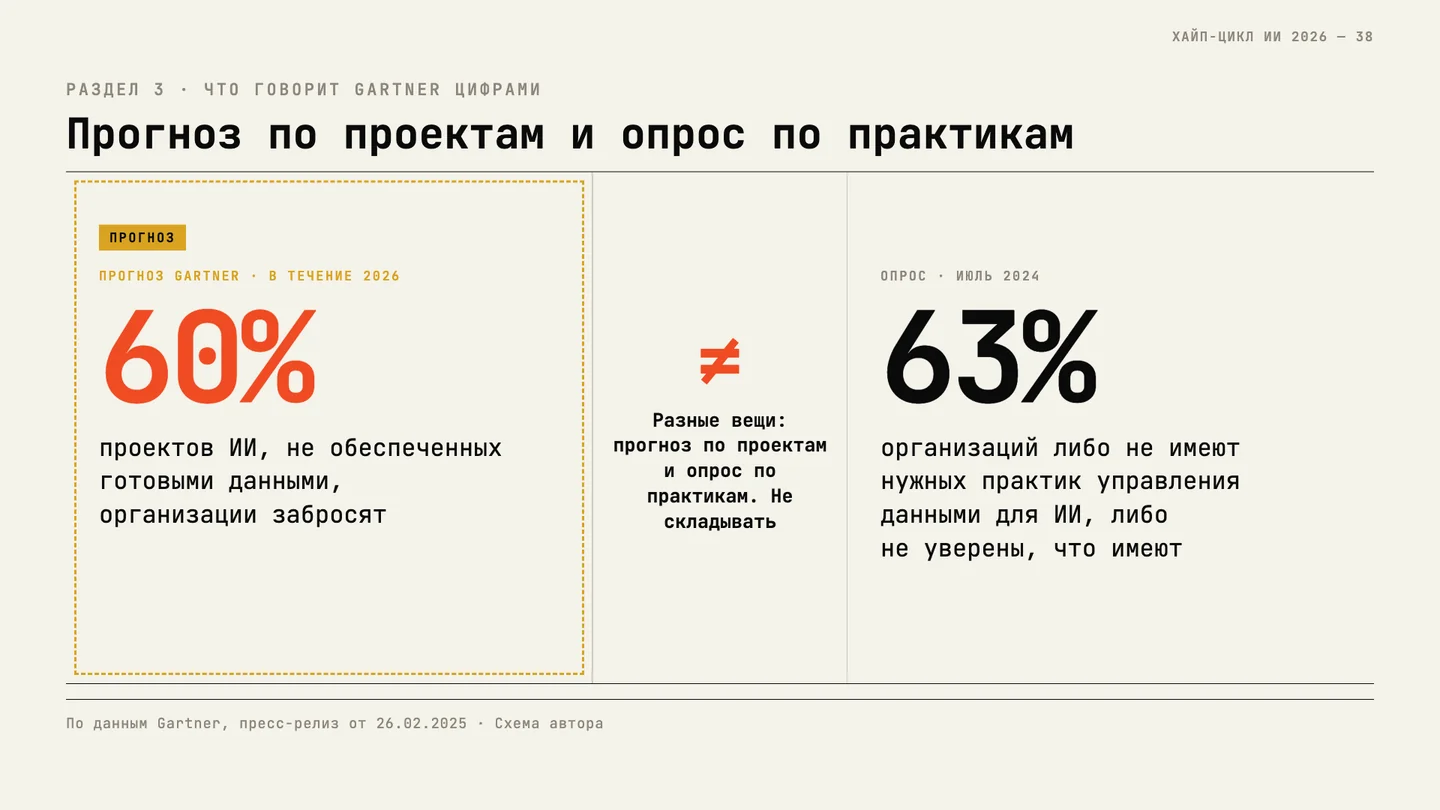
60%. Через 2026 год, пишет Gartner, организации забросят 60% проектов ИИ, не обеспеченных данными, готовыми для ИИ. Это прогноз. Горизонт у него заканчивается в этом году, но итоговой проверки от Gartner я не видел и поэтому не знаю, сбылся ли он.
63%. Столько организаций, по опросу руководителей по управлению данными (июль 2024), либо не имеют подходящих практик управления данными для ИИ, либо не уверены, что имеют. Размер выборки в разных материалах Gartner указан по-разному, поэтому число респондентов я не привожу.
Складывать эти цифры нельзя. Первая про судьбу проектов и является ожиданием. Вторая про состояние практик и является ответами в опросе. Из «63% не уверены» не следует «63% проектов провалятся».
В октябрьской статье 2026 года про сам цикл отдельного абзаца о данных, готовых для ИИ, нет. Зато есть наблюдаемость ИИ: Gartner называет её одним из самых значимых явлений цикла 2026. Речь о «тихих сбоях», то есть ответах, которые выглядят правдоподобно и неверны. Связывает ли Gartner их с данными, в открытых материалах не сказано. Моя гипотеза такая: модель, получившая устаревший прайс или два противоречащих друг другу документа, как раз и выдаёт правдоподобный и неверный ответ. С точки зрения читателя ошибка модели, а исток может лежать в папке. Это моё предположение, проверенного исследования у меня на него нет.
4. Что говорят независимые исследования
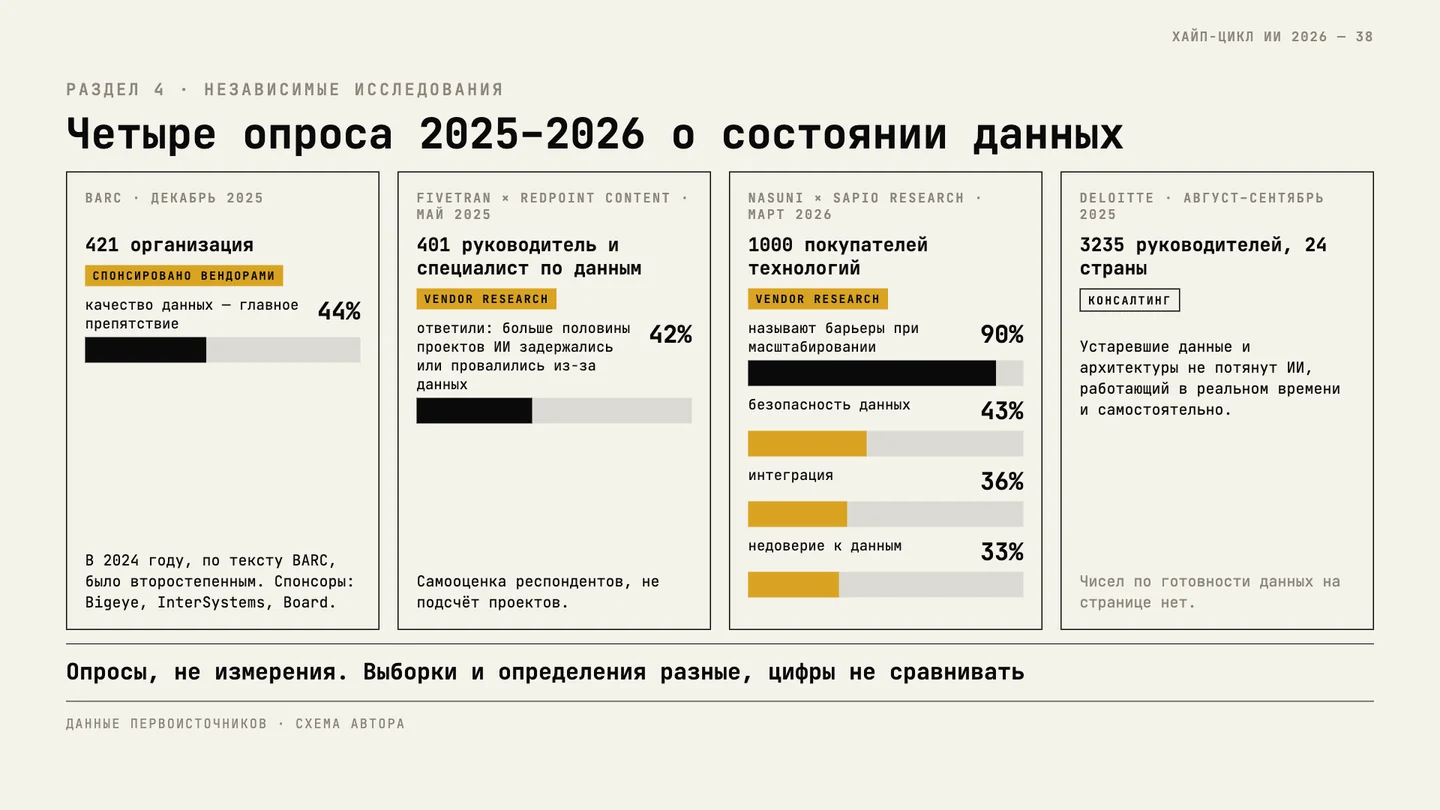
Gartner оценивает ожидания рынка. Про то, мешают ли данные в работе, пишут другие. Я нашёл четыре источника 2025–2026 годов, которые можно проверить. Предупреждение сразу: три из четырёх относятся к vendor research, то есть выпущены или оплачены компаниями, продающими продукты для работы с данными. Такие исследования заинтересованы в выводе «данные главная проблема». Читать их стоит с этой поправкой.
BARC, декабрь 2025. Исследовательская компания BARC опросила 421 организацию о том, как у них идёт внедрение ИИ. Качество данных стало главным препятствием для 44% организаций и обогнало нехватку навыков, интеграцию и бюджет. В 2024 году, по тексту BARC, оно было второстепенным. Исследование спонсировали Bigeye, InterSystems и Board. Это vendor research.
Fivetran, май 2025. Опрос провёл Redpoint Content для Fivetran, который продаёт инструменты для переноса и интеграции данных: 401 руководитель и специалист по данным в компаниях от 500 сотрудников, первый квартал 2025 года. 42% ответили, что больше половины их проектов ИИ задержались, не дотянули или провалились из-за состояния данных. Это vendor research, и это самооценка респондентов, а не независимый подсчёт проектов.
Nasuni, май 2026. Опрос Sapio Research для Nasuni, компании файлового хранения: 1000 руководителей, принимающих решения о закупках, в организациях от тысячи сотрудников в США, Великобритании, Франции и немецкоязычных странах, март 2026 года. Девяносто процентов называют барьеры при масштабировании ИИ. Чаще других звучат безопасность данных (43%), интеграция (36%) и недоверие к данным (33%). 46% говорят, что проекты ИИ вскрыли проблемы с качеством данных и управлением ими. Это тоже vendor research. И заметьте: в этом опросе первое место у безопасности, а недоверие к данным только третье.
Deloitte, 2026. Консалтинговая компания опросила 3235 руководителей в 24 странах, август–сентябрь 2025 года. На своей странице она пишет, что устаревшие данные и архитектуры не потянут ИИ, работающий в реальном времени и самостоятельно, и что единая надёжная стратегия работы с данными необходима. Числа по готовности данных на странице я не нашёл и их не привожу.
Направление у всех четырёх совпадает: данные и их состояние называют серьёзным препятствием. Цифры при этом нельзя сравнивать между собой, у каждого исследования свои вопросы, респонденты и определения. Все четыре основаны на ответах людей, а не на проверке проектов. И опрашивали людей, которые по должности отвечают за данные или покупают для них решения: им по должности естественно видеть проблему именно там. Это не отменяет вывода, но ограничивает уверенность, с которой его можно произносить.
Отдельно о том, чего здесь нет. Я не использую известную цифру «95% пилотов не дают результата» из исследования MIT NANDA: открытый оригинал я не проверял, а методологию критикуют. Опираться на неё в этой теме не стал.
5. Почему именно данные разочаровывают
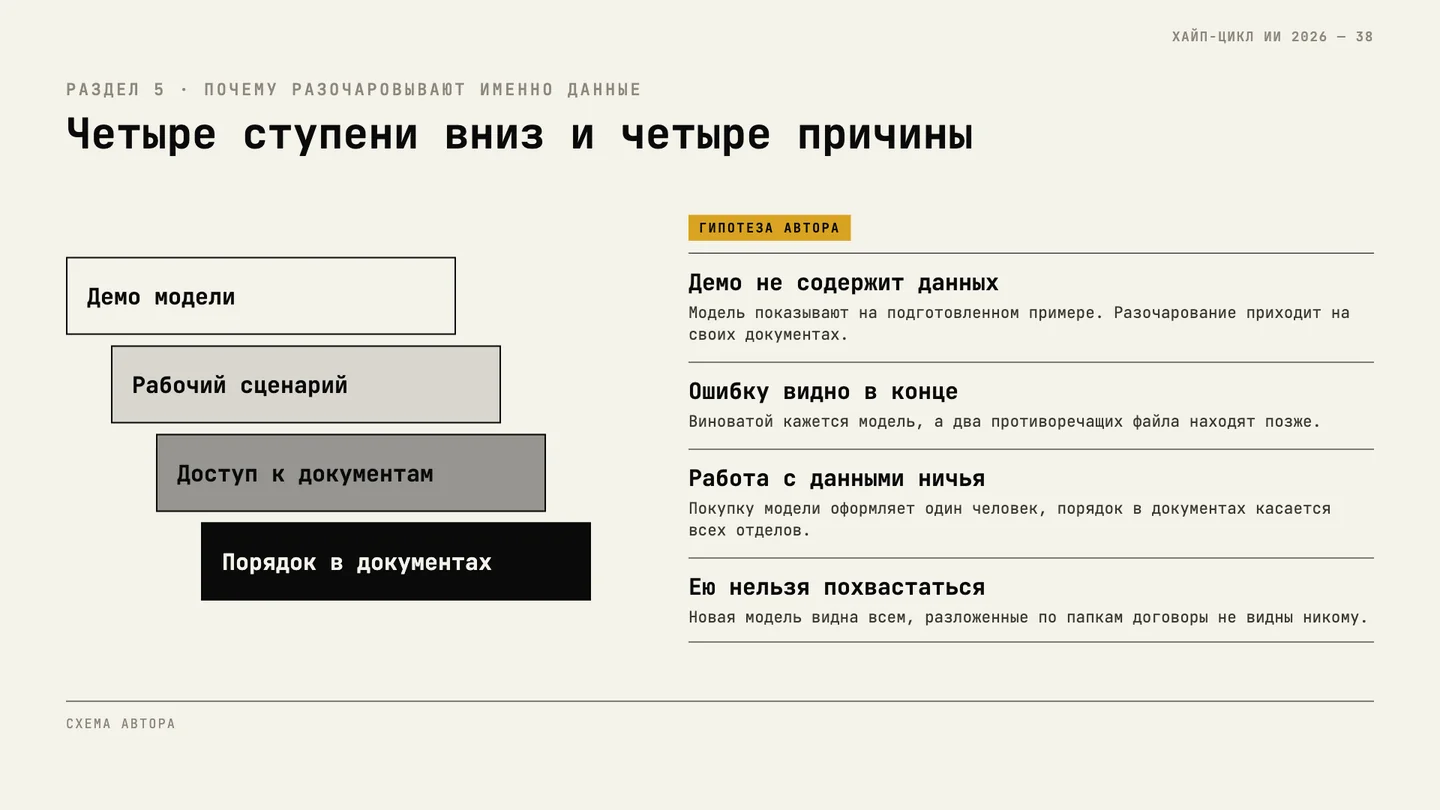
Этот раздел целиком мои гипотезы: Gartner причин не называет. Четыре объяснения согласуются с тем, что есть в источниках выше, но проверенным фактом не являются.
Демо не содержит данных. Показать модель можно за вечер на подготовленном примере. Данные нужны, когда запускаешь на своих документах, и разочарование наступает в этот момент. Ожидание было набрано на демо, жизнь проверяет его на папке.
Ошибку видно в конце. Ответ неверен, и кажется, что виновата модель. Что в источнике лежало два противоречащих файла, выясняется позже, и только если кто-то полез смотреть. Nasuni в своём опросе пишет, что проекты ИИ вскрыли проблемы с данными, и это похоже на такой же порядок: сначала запуск, потом открытие.
Работа с данными ничья. Покупку модели оформляет один человек. Порядок в документах касается всех отделов: у продаж свои таблицы, у бухгалтерии свои, у юриста своё. Пока владельца нет, разбираться никто не обязан. В моих моделях это похоже на уровень C2 из эволюции компаний: каждый отдел со своими сервисами и данными, без общего контура.
Ею нельзя похвастаться. Подключённая новая модель видна всем. Разложенные по папкам договоры не видны никому. Скучная работа проигрывает в бюджетах и в докладах, пока не становится условием запуска. Это моё наблюдение о том, как устроены решения, у меня нет на него опроса.
Всё это ответ на «почему разочаровывает». Теперь на «при чём тут я».
6. Что делать маленькой компании и одному человеку
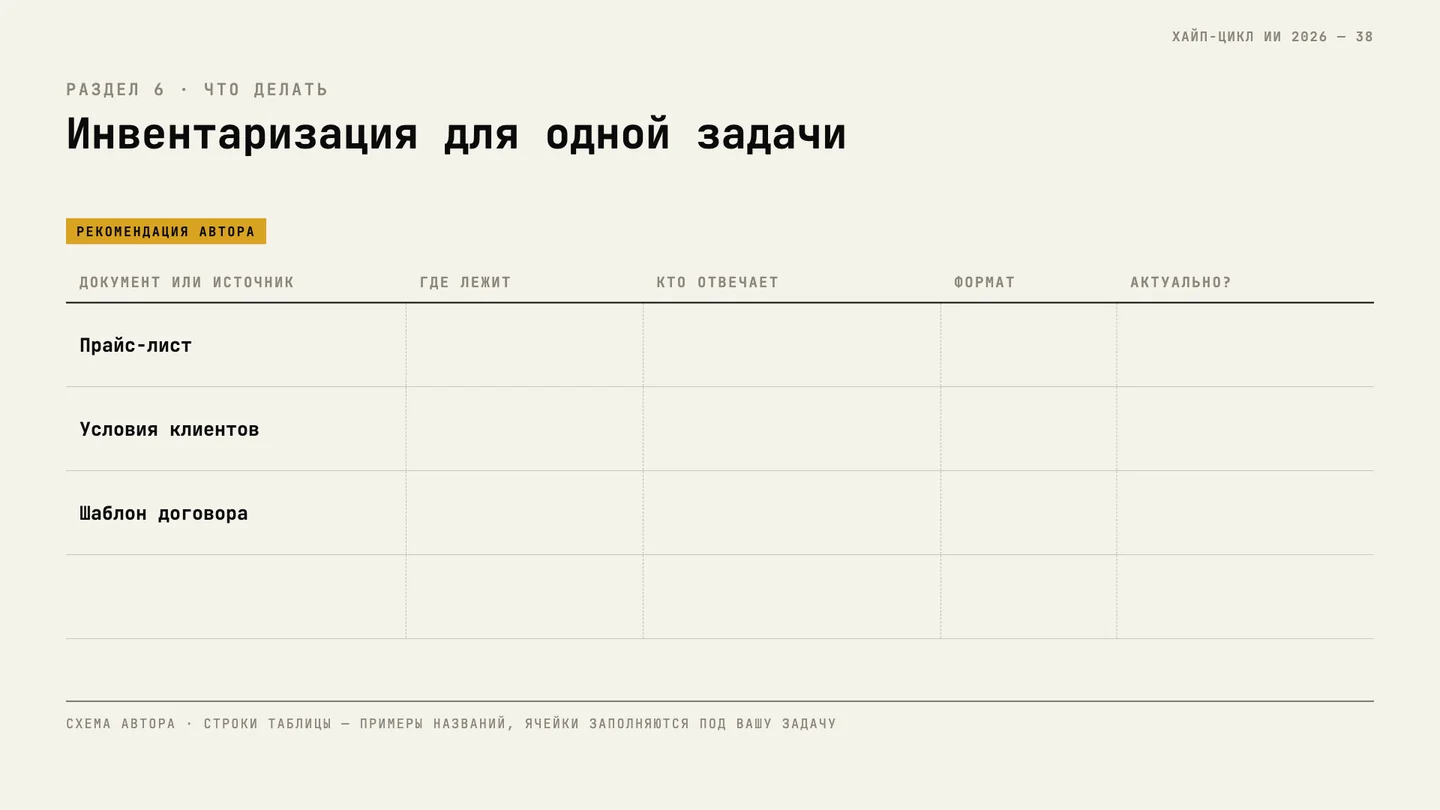
Дальше мой совет, не рекомендация Gartner. Gartner в открытых материалах рекомендаций для небольших компаний не даёт.
Главное правило берётся из определения: готовность данных зависит от задачи. Приводить в порядок всё сразу не нужно. Это самый частый способ потратить полгода и не запустить ничего.
Шаг 1. Выберите одну задачу. Формулировка «внедрить ИИ» для этого слишком широка. Подойдёт, например, ответ на типовые вопросы клиентов или подготовка коммерческого предложения. Формулировка задачи как контракта, со входом, выходом и проверкой, разобрана в статье про спецификацию. Вход этого контракта и есть ваши данные.
Шаг 2. Выпишите, что человеку понадобилось бы для этой задачи. Какие документы он открывает. Какие правила держит в голове. Когда сомневается, кого спрашивает. Десять пунктов обычно хватает. Всё, что известно только одному сотруднику, тоже запишите: они самая ценная часть списка. В терминах блога вы описываете процесс так, чтобы он мог стать продуктом: об этом «Процесс становится продуктом».
Шаг 3. По каждому пункту четыре вопроса из второго раздела. Где лежит. Кто владелец. В каком виде. Какая версия актуальна. Таблица из пяти столбцов на странице или в листе, час работы.
Шаг 4. Исправьте самое дешёвое. Одна папка для этой задачи. Дата и слово «актуально» в названии. Удалённые или перенесённые в архив дубли. Отсканированные документы пропустите через распознавание. Назначьте одного человека, который отвечает за то, чтобы папка оставалась верной.
Шаг 5. Проверьте на десяти вопросах. Задайте ИИ десять вопросов, ответы на которые вы знаете. Отметьте, где ошибся и в чём причина: модель или файл. Так вы увидите соотношение. Если причины чаще в файлах, нужна уборка данных. Если в модели, проблема уже другая. Подход с контрольными вопросами родственен тому, что описано в статье про галлюцинации: надёжность строится вокруг ненадёжной модели, и данные в этой конструкции играют роль опоры.
Для одного человека всё то же в меньшем масштабе. Ваши заметки, документы и переписка тоже данные. Если вы хотите, чтобы ИИ помогал вам с рабочей информацией, ему потребуется место, где она лежит в одном виде, с понятными названиями и датами. Придётся решить и вопрос владельца: что из личных файлов вы готовы показывать внешним сервисам, а что нет. Этот вопрос я оставляю на следующую статью.
Возвращаясь к моделям блога. Если у вас много мелких ИИ-инструментов без общего места для данных, это похоже на уровень C2, и подняться выше без порядка в данных трудно: на C3 в модели компаний появляется единый контур, в котором данные стоят в одном ряду с моделями и контролем качества. Это моё прочтение модели.
И одно предостережение. Ни одно из этих действий не гарантирует результата. Даже в порядке данные не сделают ответ верным, если задача плохо поставлена или модель слаба. Но ждать хорошего ответа, пока в источнике противоречие, бессмысленно.
Что дальше
Если данные главное препятствие, то сразу встают вопросы, чьи они и где лежат. Вы загружаете договоры и переписку в сервис, который работает на чужих серверах и в чужой юрисдикции.
На вершине графика стоит Sovereign AI, суверенный ИИ. Судя по названию и общему употреблению термина, речь о том, чтобы данные и модели оставались под контролем их владельца, но это моё прочтение. Сроки по Gartner те же, от двух до пяти лет. Определения самой Gartner для этого термина в открытых материалах я не нашёл. Про него следующая статья, «Суверенный ИИ на вершине».
Источники и данные
Gartner.
- Gartner, график Hype Cycle for Artificial Intelligence, 2026 (CTMKT_5445050), © Gartner. Оригинал в статье не воспроизводится; схемы авторские, «По данным Gartner». Положение AI-Ready Data, маркер 2–5 лет.
- Gartner, пресс-релиз «Gartner Hype Cycle Identifies Top AI Innovations in 2025», 05.08.2025 (по перепечатке, оригинал не открылся): https://www.silicon.co.uk/press-release/gartner-hype-cycle-identifies-top-ai-innovations-in-2025 — агенты и AI-ready data на пике; готовность данных определяется для конкретного применения.
- Gartner, пресс-релиз «Lack of AI-Ready Data Puts AI Projects at Risk», 26.02.2025 (страница вернула 403, цифры сверены по цитатам из выдачи): https://www.gartner.com/en/newsroom/press-releases/2025-02-26-lack-of-ai-ready-data-puts-ai-projects-at-risk — прогноз 60%, опрос 63%.
- Gartner, «The Latest Gartner Hype Cycle for Artificial Intelligence Puts Control Ahead of Capability», 01.10.2026: https://www.gartner.com/en/articles/hype-cycle-for-artificial-intelligence — наблюдаемость ИИ, «тихие сбои».
Независимые и отраслевые исследования. 5. BARC, «Global Study Maps the Reality of AI Delivery in 2025», 03.12.2025, 421 организация, спонсоры Bigeye, InterSystems, Board (vendor-sponsored): https://barc.com/news/ai-leading-edge-study/ 6. Fivetran / Redpoint Content, опрос 401 руководителя и специалиста по данным, релиз 13.05.2025 (vendor research): https://www.fivetran.com/press/fivetran-report-finds-nearly-half-of-enterprise-ai-projects-fail-due-to-poor-data-readiness 7. Nasuni, «State of Enterprise File Data Annual Report 2026», опрос Sapio Research, март 2026, 1000 респондентов, релиз 18.05.2026 (vendor research): https://www.prnewswire.com/news-releases/nasuni-research-finds-97-of-enterprises-are-adopting-ai-agents-yet-most-projects-fail-to-meet-objectives-302772896.html 8. Deloitte, «State of AI in the Enterprise» (отчёт 2026), 3235 руководителей, 24 страны, август–сентябрь 2025: https://www.deloitte.com/global/en/issues/generative-ai/state-of-ai-in-enterprise.html
Авторские концепции и статьи блога. Эволюция компаний C0–C5; Процесс становится продуктом; Промпт — пожелание, спека — контракт; Галлюцинации.